人型ロボット、初めて入る30軒の家で家事3課題。Figure「Helix 2.5」の完全成功は420回中237回(56%)
人型ロボット、初めて入る30軒の家で家事3課題。Figure「Helix 2.5」の完全成功は420回中237回(56%)【2026年9月】
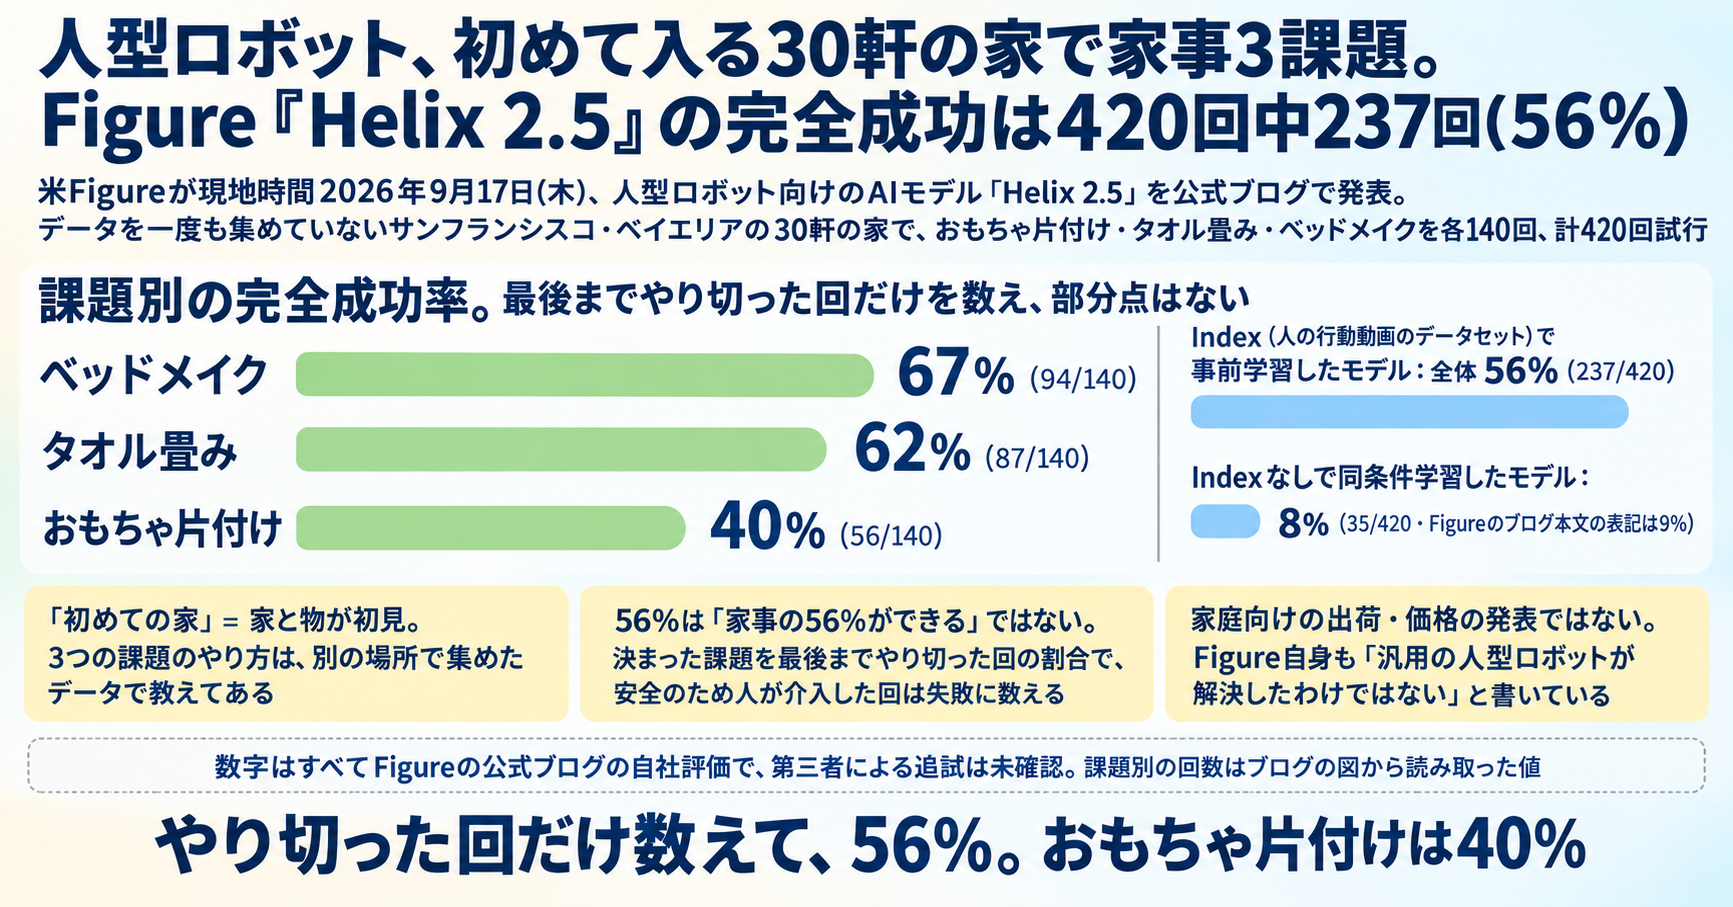
米Figureが、人型ロボット向けのAIモデル「Helix 2.5」を発表しました (現地時間2026年9月17日(木)・同社公式ブログ)。データを一度も集めていないサンフランシスコ・ベイエリアの30軒の家に人型ロボットを持ち込み、おもちゃの片付け・タオル畳み・ベッドメイクの3課題を計420回試行したところ、最後までやり切った完全成功は237回 (56%) だった、と同社は説明しています。
「初めて入る家で、その場で家事をする」という言い方は、同社の原文にあるものです。同時に、ゼロショット (その場所や物で一度も練習せずに初見でやること) の範囲は家と物に限られ、課題のやり方は別の場所で教えてあります。成功率の定義と、Figure自身と同業他社がこの数字をどう読んでいるかを、発表の範囲で確かめます。
この記事のポイント
- Figureが「Helix 2.5」を発表。人の行動動画データセット「Index」だけでゼロから事前学習 (特定の課題を教える前に、大量のデータで土台を作る学習) し、1つの土台モデルに3つの課題を追加で教えた (現地時間2026年9月17日(木))
- 30軒の未知の家で420回試行、完全成功は237回 (56%)。部分点はなく、安全のため人が介入した回は失敗に数える (同社発表)
- 課題別はベッドメイク67%・タオル畳み62%・おもちゃ片付け40%。Indexなしで同条件学習したモデルは合計35回 (チャートでは8%、Figureのブログ本文では9%)
- 「ゼロショット」は家と物についての語。課題は別の場所で集めたデータで教えており、何も教えずに家事を覚えた話とは別
- 評価は同社内で、第三者検証は未確認。出荷時期や価格の発表とは別で、Figure自身も「解決したわけではない」と書いている
何が起きたのか
Figureは米国の人型ロボット企業で、Helixはそのロボットを動かすAIモデルの名前です。前版のHelix 02 (2026年1月公開) は、ロボットが働く場所で集めたデータから学んでいた、と同社は今回のブログで振り返っています。
Helix 2.5の新しさは、学び方にあります。同社によると、Index (Figureが集めている人間の行動動画のデータセット。一般の人がスマホアプリで家事や仕事を自撮りして投稿し、対価を受け取る) だけを使い、事前学習をゼロから行いました。文章AIと同じ作り方を、ロボットの全身動作に持ち込んだ形です。
その土台の上に、リビングの片付け・タオル畳み・ベッドメイクの3つの行動を、別の場所で集めた微調整データ (課題のやり方を教えるための追加データ) で教えました。教えたモデルを、評価する家ではデータ収集も調整もせずに、そのまま持ち込んでいます。
30軒・420回・完全成功56%の中身
評価の条件は、同社ブログの付録にあるとおりです。30軒はいずれもロボットが初めて入る家で、家にあるソファやベッド、作業台をそのまま使います。評価に使ったおもちゃ・タオル・寝具は課題を教えたデータに出てこないものを選び、初期配置は毎回、人が投げ散らかしたり乱したりして変えています。課題ごとに1つのチェックポイント (学習途中で保存したモデルの状態) を30軒すべてで使い回し、家ごとの調整はしていません。
成功の定義も課題ごとに決まっています。片付けは、散らばった13〜15個のおもちゃを全部かごに入れる (1個につき1分)。タオル畳みは、全部を畳んでかごに入れる (1枚につき3分)。ベッドメイクは、枕2つと掛け布団の角を上に置き、掛け布団を平らにする (要素ごとに1分)。制限時間を超えた回と、安全のために人が介入した回は、失敗として数えます。部分点はありません。
この定義で、3課題×140回=420回のうち、完全成功は237回でした。課題別に見ると、ベッドメイク94回 (67%)、タオル畳み87回 (62%)、おもちゃ片付け56回 (40%) で、床に散らばった物を拾い集める課題が最も低くなっています。Indexを使わずに同じ条件で学習したモデルは、合計35回 (8%) でした。
Figure自身と同業他社の読み方
同社はブログの中で、汎用の人型ロボットが解決したわけではない、と自ら書いています。ゼロショットという語も、評価した家と操作した物についてのもので、課題は微調整データで指定した、と原文が範囲を限定した書き方です。
同業のSunday Robotics共同創業者Tony Zhao氏らは、DeepTech (MIT Technology Review中国版) の2026年9月18日(金)の記事によると、237/420という完全成功率に疑問を呈しました。同記事はこれを、完全な課題では半分近くが失敗する意味だと説明し、役に立つ仕事には成功率だけでなく信頼性の見方が要る、と論じています。同記事はSunday社の衣類畳みの成功率99.1%を対比に挙げていますが、こちらもSunday社の自社数字で、課題も条件も別です。
動画の編集や遠隔操作の有無について、Figureのブログ本文に明示の記述はありません。同社が根拠として示しているのは「自律」という表現と、人が介入した試行を失敗に数える採点規則です。Humanoids Daily (2026年9月17日(木)) によると、CEOのBrett Adcock氏は約4時間の延長映像をXに投稿しており、同メディアはこの映像だけで420回の完全な記録にはならないと注記しています。
数字の読み方 (自社評価と、チャートと本文の二つの数字)
30軒・420回・237回という数字は、すべてFigureの社内評価です。同社は「blind evaluations」(評価する家の事前情報なしの評価) と表現していますが、第三者機関による追試は2026年9月19日(土)時点で未確認です。「業界初」にあたる記述も、原文は「我々の知る限り」という限定つきです。
Indexなしの成功率は、チャートでは35/420 (8%)、本文では9%と書かれています。課題別のIndexなしはタオル9%・おもちゃ5%・ベッド11%で、本文の9%がどの集計に基づくかはブログに説明がありません。両方を使うときは、チャートの値と本文の表現を分けて引く必要があります。
評価に使った台数、評価期間、1回あたりの所要時間、出荷台数や価格は未公表です。
日本の読者にとっての意味
人型ロボットの発表を読むときに手元に置いておきたいのは、成功率の定義です。今回の発表はその定義を付録まで公開しているので、次に同じ種類の数字を読むときの練習台です。「片付けができた」が、13〜15個を全部かごに入れて1個1分以内、と決まって初めて、56%は比べられる数字になります。人が手を出した回を失敗に数える規則があるかどうかでも、同じ56%の重さは別物です。何が初めてで何が教え済みかも同じで、今回は家と物が初めてで、課題のやり方は教えてあります。
評価はサンフランシスコ・ベイエリアの30軒で、畳や布団、狭い動線といった日本の家での試行は今後の課題として残っています。Indexのアプリは2026年8月時点で108か国からダウンロードされていると同社は説明していますが、日本での提供状況は未確認です。Quotidiaが次回の比較点に置くのは、最も低かったおもちゃ片付けの40%です。
まとめ(FAQ)
Q. 人型ロボットが家事をこなす段階になったのですか?
A. 今回は研究成果の実験報告で、出荷や価格、家庭向け提供は発表の範囲外です。3つの決まった課題を最後までやり切れたのが420回中237回で、Figure自身も汎用の人型ロボットはまだ途中だと位置づけています。
Q. 「初めての家」で、何も教えずに家事を覚えたのですか?
A. 初めてなのは家と、そこにある物です。おもちゃ片付け・タオル畳み・ベッドメイクのやり方は、別の場所で集めたデータで教えてあります。
Q. 56%は「家事の56%ができる」という意味ですか?
A. 課題ごとに決めた完了条件を満たした試行の割合です。おもちゃ片付けは40%、ベッドメイクは67%と課題で差があります。
Q. 遠隔操作や編集の有無は確認できますか?
A. Figureのブログに明示の記述はなく、採点規則として、安全のため人が介入した試行は失敗に数えると書かれています。第三者による追試も、2026年9月19日(土)時点で未確認です。
検証メモ(出典と確認の範囲)
- 本記事の数字は、Figureの公式ブログ (現地時間2026年9月17日(木)) の本文・図1のチャート・付録の採点基準に基づきます。日本語では日本時間2026年9月18日(金)にロボスタが報じています。米国時間の発表時刻は確認していません。
- 課題別の回数 (94/140・87/140・56/140・Indexなし12/7/16) は図1のチャートから読み取った値です。本文は「9%から56%」と表記しています。
- 「ゼロショット」の範囲とチェックポイントの固定は同ブログの本文、初期配置の乱し方は本文の表1、成功の定義と制限時間、人が介入した試行の扱いは付録の記述です。
- 遠隔操作や動画の編集の有無について、ブログ本文に明示の記述はありません。Brett Adcock氏の約4時間の延長映像は、Humanoids Daily (2026年9月17日(木)) の記載で、X本体は確認していません。
- Tony Zhao氏の発言はDeepTech (MIT Technology Review中国版・2026年9月18日(金)) の記事によります。X上の原文は確認していません。Sunday社の99.1%は同社の自社数字です。
- 評価は同社内で行われたもので、第三者機関の追試は2026年9月19日(土)時点で確認していません。The Verge・Ars Technica・IEEE Spectrumの記事の有無も未確認です。
- 評価に使った機体名 (Figure 03) は二次報道の記載で、ブログ本文には明記がありません。台数・評価期間・所要時間・出荷や価格は公表されていません。
- Indexの数字 (108か国) は同社の2026年8月25日(火)の記事によります。
- 日付は日本時間で記載しています。掲載日 (2026年9月22日(火)) 時点の情報です。
Quotidia の視点
Physical AI (ロボットのように体を持って動く AI) の発表では、見出しの動詞より先に採点規則を探すことにしている。今回のFigureは、その規則を付録に全部書いた。部分点なし、制限時間あり、安全のため人が手を出した回は失敗、家と物は初見で課題は教え済み。この規則の下での56%は、見出しの「初めての家で家事」より厳しい数字で、同時に、自社内の評価で第三者の追試がまだない数字でもある。Sunday RoboticsのTony Zhao氏らの疑問 (DeepTechの言い方では「半分近くは失敗」) と、Figure自身の「解決したわけではない」は、同じ237回を反対側から見ていて、どちらも数字を動かさない。次回の比較点は、3課題の中で最も低いおもちゃ片付けの40%に置く。散らかり方が毎回違う床から13〜15個を拾い集める課題は、家と物が初見であることの負荷が最も直接に出る場所で、「初めての家」という見出しの重さはここで決まる。日本の家 (畳・布団・狭い動線) での数字は今回ない。人型ロボットが家に来る日の話は、その数字が出てからでよい。
関連記事:
- ファナック、図面をカメラに見せるだけで溶接するロボットを発表。教示ゼロの「AI溶接エージェント」、12月末出荷(ファナックが図面をカメラに見せるだけで溶接動作を生成する「AI溶接エージェント」を発表した回。あちらは工場の決まった作業で教示をゼロにする話、今回は家という未知の環境で全身動作を汎化させる実験報告。同じPhysical AIの、決まった場所と初めての場所の対)
- ロボットに「つかむ」を教えるのは人の手袋。アトムが豊洲に開いた学習データ工場と、200台・30万時間の目標(アトムが豊洲に開いた学習データ工場で、人の手袋から「つかむ」のデータを集める回。あちらは専用の場所で人が装置を着けて集めるデータ、今回のIndexは一般の人がスマホで自撮りした家事や仕事の動画。ロボットに教えるデータの、集め方の対)
- 1つのAIが人型ロボットの脚から指先まで動かす。Googleの「Gemini Robotics 2」発表(Googleが1つのAIで人型ロボットの脚から指先まで動かす「Gemini Robotics 2」を発表した回。あちらは1つのモデルで全身を動かす設計の話、今回は1つのモデルを初めての30軒に持ち込んで成功率を数えた話。全身モデルの、設計と実測の対)
二十三番の木札
敬老の日の夕方、知らない町の銭湯の入口で、僕は靴の紐をほどいていた。調べて書く仕事でこの町に来て三日目で、宿の風呂は膝を折らないと肩まで入らない。地図で煙突を見つけて、歩いてきた。
下足箱の戸は木で、閉めると木札が抜ける。戸は五十あって、埋まっているのは十ほどだった。僕の戸は二十三番で、木札には松の焼き印がある。乾いた蒲鉾板みたいに軽い。この札をどうするのかは、どこにも書いていない。番台の人はテレビの相撲を見ていて、僕は訊かなかった。
隣の戸の前に、小柄な年配の女の人が立っていた。白い手ぬぐいと小さなビニール袋を提げて、抜いたばかりの木札を裏返して眺めている。
「これ、持って入るの。渡すの」と彼女は言った。僕にというより、木札に。
「持って入るんだと思います。僕も初めてで」
「初めて同士ね」。木札が、袋の底に落ちた。「うちの町のは、去年たこ焼き屋になったの」
「それは」
「たこ焼きのほうは、おいしい」
暖簾の内側でも、訊きたいことは同じだけあった。脱衣かごは籐で、ロッカーはない。かごを棚のどこに置くかで、常連かどうかが分かる並びになっている。僕は端の空いた棚に置いた。洗い場のカランは押すと十秒で止まり、湯船は三つあって、手前から順に熱くなる。天井が高くて、桶の音が二度聞こえる。壁の絵は富士山ではなく、灯台だった。
手前の湯に、肩まで入った。温度計は四十三度を指している。針を立てたように熱くて、汗が出るより先に膝の裏が痛くなった。町の人は平気な顔で浸かっている。三十まで数えて、一度出た。
Figure というアメリカの会社が、アメリカの木曜日に、Helix 2.5 という人型ロボットの新しい頭脳を発表した。Index と呼ぶ、人が自分の家事や仕事をスマホで撮った動画の山だけで、その頭脳の土台を作っている。ロボットを、データを一度も集めていない三十軒の家に連れて行き、床のおもちゃの片付けと、タオル畳みと、ベッドメイクをさせる。家も、床に転がっているおもちゃも、そのロボットには初めての物だ。やり方だけは、別の場所で教えてある。三十軒で四百二十回やって、最後までやり切れたのが二百三十七回。半分と、少し。途中まででは数えない。人が危ないと思って手を出した回は、失敗に入れる。その動画を、僕は宿で三度見た。書く仕事のほうが、それを待っている。
同じ商売の Sunday Robotics の Tony Zhao という人は、その数字を疑った。伝えた記事は、半分近くは失敗している、と書いた。Figure のほうも、これで解決したとは言わない、と自分で書いている。湯気の向こうで、灯台の絵が少し歪んで見えた。湯の縁に腰をかけて、僕は二十三番の木札を、洗面器の脇に置き直した。
脱衣所で体を拭いていると、彼女はもう着替え終えていて、番台の横で瓶の牛乳を飲んでいた。百三十円、と手書きの紙が貼ってある。牛乳を飲む人は、ほかに二人いた。髪が濡れていて、顔は湯の色をしている。
「熱かった?」と彼女は言った。
「一度、出ました」
「私は水を足した。番台の人は見てたけど、何も言わなかった」
「うちの町のが風呂だった頃は、ぬるかったの。夏は子どもが入ったまま寝た」。瓶を明かりに透かして、残りを飲んだ。
水を足すのは、あの数え方ならどちらに入るのだろう。人が手を出した回は、失敗に入る。手を出したのが、入っている本人なら。そこまで考えて、僕は止めた。
僕のほうは、足さずに一度出て、もう一度入って、三十を二回数えた。四百二十回のうちの一回だったら、失敗の側に置かれる回だ。明日の原稿で、二百三十七回を、成功が半分と書くか、失敗が半分と書くか、まだ決めていない。同じ数字を前にして、一行目だけが空いている。
「明日も来るの」
「明日は帰ります」
「私は明日も」。瓶が番台に戻った。「湯の熱さは、明日は番台に訊く」
二人で下足箱の前に戻った。袋の底から木札が出てきて、十一番の戸に差さった。戸は乾いた音を立てて開き、緑のサンダルが出てきた。僕の戸を閉めたときより、軽い音だった。
暖簾の外は、まだ明るかった。煙突の影が通りを横切って、向かいの理髪店の看板にかかっている。犬を連れた人が暖簾の前で立ち止まり、また歩き出した。彼女は右へ曲がり、角の手前で一度だけ手ぬぐいを振った。
二十三番の木札を戸に差して、僕は靴を出した。紐を結び、暖簾をくぐって、二度目の道を宿へ歩いた。
Figure、人型ロボット向けAI「Helix 2.5」を発表。初めて入る30軒の家で家事3課題、完全成功は420回中237回 (56%)
米Figureは現地時間2026年9月17日(木)、人型ロボット向けのAIモデル「Helix 2.5」を公式ブログで発表した。人の行動動画データセット「Index」のみでゼロから事前学習し、データを一切集めていないサンフランシスコ・ベイエリアの30軒の家で、おもちゃ片付け・タオル畳み・ベッドメイクの3課題を計420回試行。完全成功は237回 (56%) で、部分点はない。課題別はベッドメイク94/140 (67%)、タオル畳み87/140 (62%)、おもちゃ片付け56/140 (40%)。Indexを使わず同条件で学習したモデルは合計35/420 (8%) で、同社本文は「9%」と表記している。「ゼロショット」は評価する家と操作する物についての語で、課題は別の場所で集めた微調整データで教えた。課題ごとに1つのチェックポイントを30軒すべてで使い、初期配置は人が毎回乱している。安全のため人が介入した試行は中止・失敗扱いで、制限時間 (おもちゃ1個1分・タオル1枚3分・ベッド要素ごと1分) の超過も失敗である。評価は同社内の実施で第三者検証はなく、出荷時期・価格・台数は未公表。Figure自身は「汎用の人型ロボットが解決済みという意味ではない」と記し、同業Sunday Roboticsの共同創業者Tony Zhao氏らはDeepTech (2026年9月18日(金)) によると237/420という完全成功率に疑問を呈し、同記事はこれを半分近くが失敗する意味だと説明している。一次資料はFigure公式ブログ (現地時間2026年9月17日(木))。
運営: AI Quotidia 編集部
海外 AI ニュースを毎朝、日本語で解説する個人運営メディアです。記事は AI を活用して作成し、人手による確認・編集を経て公開しています。