相づちを打ち、話し終わる前に返事を始める。Shizuku AIが日本語の音声AI「Shizuku-Duplex」を開発
相づちを打ち、話し終わる前に返事を始める。Shizuku AIが日本語の音声AI「Shizuku-Duplex」を開発【2026年11月】
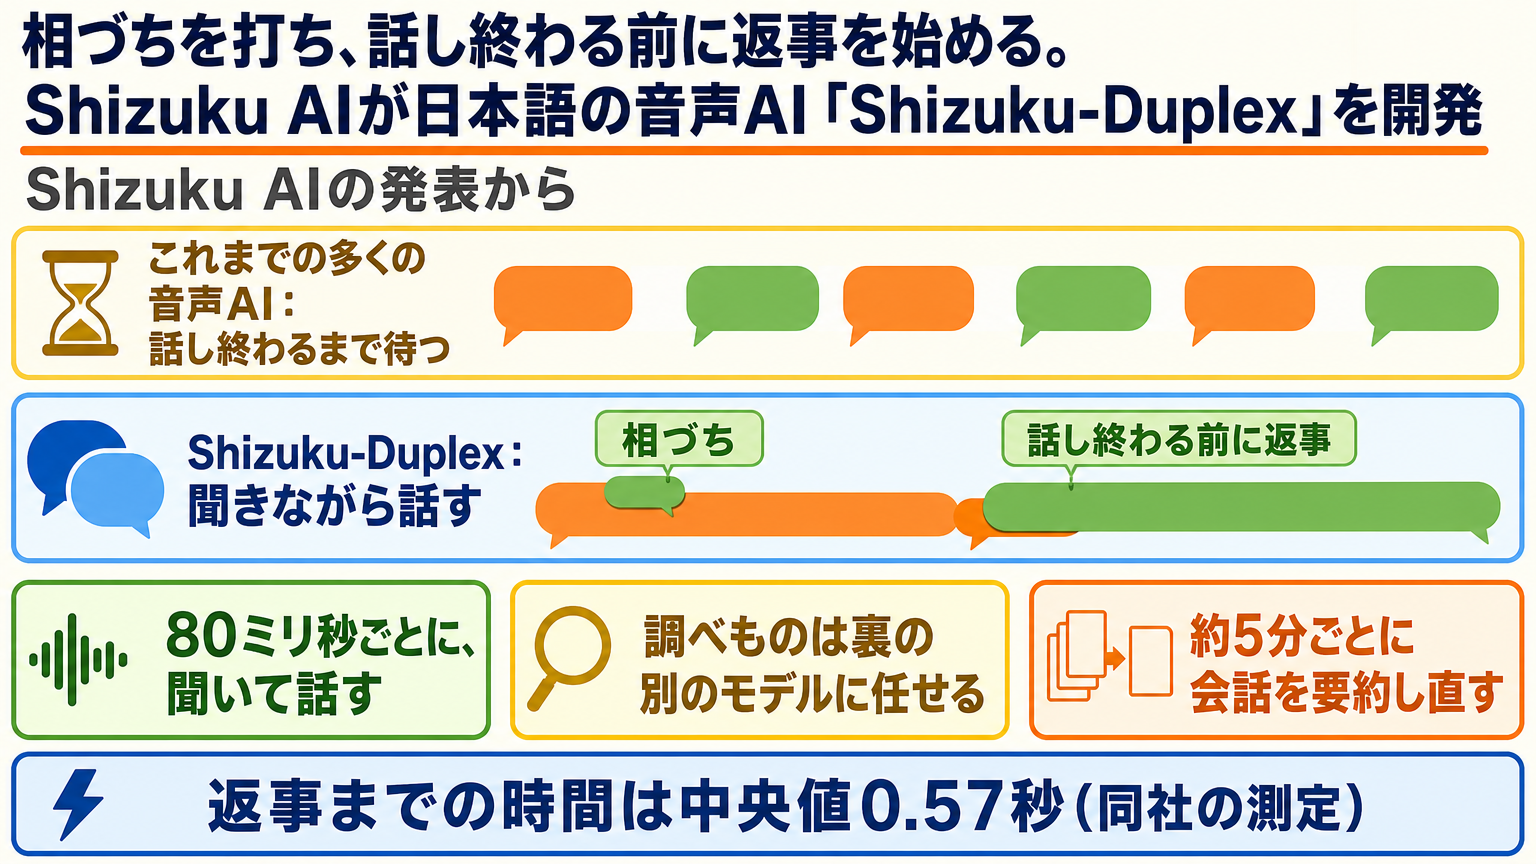
日本のスタートアップShizuku AIは2026年11月8日(日)、80ミリ秒ごとに相手の声を聞きながら自分の声を出す日本語の音声対話モデル「Shizuku-Duplex」を開発したと、同社のブログで発表しました。Full-Duplex (全二重・電話のように、聞くことと話すことを同時にできる方式) をとり、相づち (相手の話の途中で「うん」「なるほど」などと短く返す声) を打ち、話し終わりを待たずに返事を始められます。同社の測定では、話し終わりから返事までの時間は中央値で0.57秒です。難しい調べものは裏で動く別のモデルに任せ、結果を待つあいだも会話を続けます。ブログには会話のデモ動画が載っていますが、一般の人が話せる時期や方法、料金は書かれていません。
この記事のポイント
- Shizuku AIが2026年11月8日(日)、聞きながら話せる日本語の音声対話モデル「Shizuku-Duplex」を開発したと発表した
- 80ミリ秒ごとに相手の声を聞いて自分の声を出し、いつ話し始め、いつ黙るかをモデル自身が決める
- 調べものは裏の別モデルが担当し、会話を担うモデルは待つあいだも受け答えを続ける
- 約5分ごとに会話を要約して作り直し、長い会話でも応答が崩れないようにしている
- 一般の人が話せる時期・方法・料金は、発表に書かれていない
Shizuku-Duplexとは
Shizuku-Duplexとは、Shizuku AIが開発した、相手の声を聞いている最中にも話せる日本語の音声対話モデルです。Shizuku AIは、AIキャラクター「しずく」を手がける日本のスタートアップです。同社はブログの冒頭で、「人どうしのような自然な間合いで話せる」モデルだと紹介しています。
これまでの音声AIとの違い
Full-Duplex (全二重) とは、電話のように、聞くことと話すことを同時に行う方式です。
同社の説明によると、これまでの音声AIの多くは、音声認識、LLM (大規模言語モデル)、音声合成をつないだ作り (カスケード型) です。相手の話し終わりを検知してから順に処理するため、返事を待たされ、途中で口をはさめず、相づちもありませんでした。
| これまでの多くの音声AI (カスケード型) | Shizuku-Duplex (Full-Duplex) | |
|---|---|---|
| 聞くことと話すこと | 順番に行う | 同時に行う |
| 返事を始めるとき | 相手の話し終わりを検知してから | 話し終わりを待たずに返せる |
| 相づち | 打たない | 打つ |
| 話し始めと黙るタイミング | 話し終わりの検知で決まる | モデル自身が決める |
ブログの例では、「京都に行くんだけど、おすすめある?」という問いかけに、「嵐山はどうですか?竹林がきれいで…」と返しています。
80ミリ秒ごとに聞いて話す仕組み
Shizuku-Duplexは、80ミリ秒を1つの区切り (tick) として、区切りごとにユーザーの声を聞き、自分の声を出します。黙っているあいだも、話しているあいだも、相手の声はずっと聞こえています。
- Inner Monologue (ひとりごと): 声に出す内容を、声より少し先にテキストで書き出しておく
- 高速化: TensorRTやTritonのカーネルを使った推論の最適化で、区切りごとの処理を80ミリ秒以内に終える
- 構成: LLMを土台にしたTransformerで、出力は音声・テキスト・Actionの3つ。Actionは、話しているあいだの気持ちに合ったモーション (Live2Dの動き) を選ぶものだと同社は説明しています
調べものは裏の別モデルが担当
会話を担うinteraction modelと、会話とは別に裏で難しい依頼をこなすbackground modelに分かれています。background modelはWeb検索などのツールを使えます。そのあいだもinteraction modelは受け答えを続け、届いた結果を自分の言葉で伝えます。
ブログの例では、2人で予算10万円の京都旅行を相談すると、まず「プランをいくつか探してみますね」と返し、後から「京都で三泊なら、宿代がかなりポイントになりそうです」と続けます。
長い会話を続ける工夫
同社は他の研究を引いて、Full-Duplexのモデルは黙っているあいだもコンテキスト (AIが参照する会話の履歴) が伸び続け、会話が長くなると応答が崩れていくと説明しています。Shizuku-Duplexは約5分ごとに対話の内容を要約してコンテキストを作り直し (Auto-Compaction)、その切り替えを1つの区切り (80ミリ秒) 以内に処理して、会話を途切れさせないようにしています。
同社の評価
日本語のFull-Duplexモデルを評価できるベンチマークがまだ十分にないため、同社は英語のFull-Duplex-Benchと、日本語を含むM3-DuplexBenchを参考に日本語版のベンチマーク (性能を比べるための試験) を自作しました。出力した音声をHaas-ja-v1.0で書き起こし、内容の採点はClaude Opus 5.5にさせています。比較したのは、Full-DuplexのGPT-Live (OpenAI)・J-Moshi・LLM-jp-Moshiと、参考としてFull-DuplexではないGPT-Realtime (OpenAI) とGemini Live (Google) です。
同社の結果では、話す番の受け渡し (ターンテイキング) の6つの指標のうち5つでFull-Duplexのモデルとして最良でした。応答の内容は、Full-Duplexのモデルの中でGPT-Liveに次ぐ性能で、既存の日本語Full-Duplexモデルを大きく上回ったとしています。
| モデル | 話し終わりから返事までの時間 (中央値) | 測り方 |
|---|---|---|
| Shizuku-Duplex | 0.57秒 | サーバー側の録音 (通信の往復を含まない) |
| GPT-Live | 0.53秒 | サーバー側の録音 (通信の往復を含まない) |
| Gemini Live | 1.27秒 | 手元で再生した時刻 (通信の往復 中央値0.04秒を含む) |
| GPT-Realtime | 1.61秒 | 手元で再生した時刻 (通信の往復 中央値0.14秒を含む) |
この表を含め、評価はすべて同社が自作した試験と測定によるもので、測り方は上の列のとおりそろっていません。
同社は、GPT-RealtimeとGemini Liveについて、ユーザーが割り込むと必ず話をやめるが、相づちのような短い声でもほとんど黙ってしまう、と書いています。
Shizuku AIが目指すもの
同社は目指すものを「AI キャラクターが、いつか一人ひとりのそばで一緒に暮らす未来」と書いています。GPT-Liveは誰にでも同じように応える賢いアシスタント、しずくは人とのやり取りの中で育っていくAIキャラクター、という対比です。
これからは、対話能力の改善と対応言語の拡充、音声に加えてVision (視覚) やAction (動き) への対応を進めるとしています。
まだ分かっていないこと
- 一般の人がShizuku-Duplexと話せる時期と方法 (アプリ、Web、APIのどれか)
- 料金
- モデルの重みや評価のデータを公開するかどうか
- 土台にしたLLMの名前と、モデルの大きさ
まとめ(FAQ)
Q. Shizuku-Duplexは今すぐ使えますか?
A. 発表は開発とデモ動画の公開までで、一般の人が話せる時期や方法、料金はブログに書かれていません。
Q. これまでの音声AIと何が違うのですか?
A. 多くの音声AIは相手が話し終わるのを待ってから順に返事を作ります。Shizuku-Duplexは聞きながら話すので、相づちを打ち、話し終わりを待たずに返事を始められます。
Q. 返事はどれくらい速いのですか?
A. 同社の測定では、話し終わりから返事までの時間は中央値で0.57秒です。比べたモデルとは測り方がそろっていない部分があり、同社が自作した試験による数字です。
Q. GPT-Liveより性能が上なのですか?
A. 同社の評価では、話す番の受け渡しの6指標のうち5つでFull-Duplexのモデルとして最良でしたが、応答の内容はGPT-Liveに次ぐ性能です。総合でGPT-Liveを上回ったとは書いていません。
検証メモ(出典と確認の範囲)
- Shizuku AIの公式ブログ「Shizuku-Duplex:自然な間合いで話す日本語 Full-Duplex モデル」(2026年11月8日(日)) を全文で確認しました。仕組み、数字、評価の方法と結果、目指すもの、今後の予定はこのブログによります。本文に時刻の記載はありません。
- ブログ内のデモ動画と図の画像は確認の範囲外です。実際の会話がどう聞こえるかは確かめていません。
- 評価は同社が自作した日本語のベンチマークによるもので、内容の採点はClaude Opus 5.5が行っています。第三者による検証ではありません。評価したのは日本語で利用できる主なモデルで、すべてではないと同社は注記しています。
- 同社はShizuku-Duplexを「GPT-Live を除けば、日本語で賢い対話ができる初めての Full-Duplex モデル」と位置づけていますが、この点はQuotidiaでは確認していません。
- 同社のXの投稿本文、会社概要 (登記上の社名・所在地・代表者・従業員数) は確認の範囲外です。
- 日本語以外への対応は、ブログでは今後の課題 (対応言語の拡充) として挙げられているだけです。
- GIGAZINE (2026年11月9日(月)) の紹介記事は、同社ブログとXの投稿の紹介で、独自の取材や検証はありません。事実の出典には使っていません。
- 2026年11月9日(月) 時点の確認による情報です。
Quotidia の視点
Shizuku-Duplexは、黙っているあいだも相手の声を聞き続け、いつ話し始めるかを自分で決める。発表の中でいちばん具体的に書かれているのは、この沈黙の扱いだ。調べものを裏のモデルに回して会話を切らさない作りも、約5分ごとに会話を要約し直す工夫も、会話に空白を作らないための設計として読める。電話の自動応答で、言い終わるまで待ち、相づちを打つと案内が止まることに慣れた人ほど、この違いは分かりやすいはずだ。一方で、0.57秒をはじめとする数字は同社が自作した試験によるもので、応答の中身の採点もAIにさせている。他社との秒数の比較も、同じ条件で測ったものではない。どう聞こえるかは、まずブログのデモ動画で確かめられる。一般の人が話せる時期は、まだ示されていない。
関連記事:
- ドコモ、相手の様子を察する音声対話の技術を発表。EQの要素を入れたAIと話すと、人の話す量は4割多かった(ドコモが、声の調子や話の中身から相手の様子を察して応じ方を変える音声対話の技術を発表した回。あちらは何をどう返すかの話で、今回は話す番をいつ受け渡すかの話)
月曜の十二時のラリー
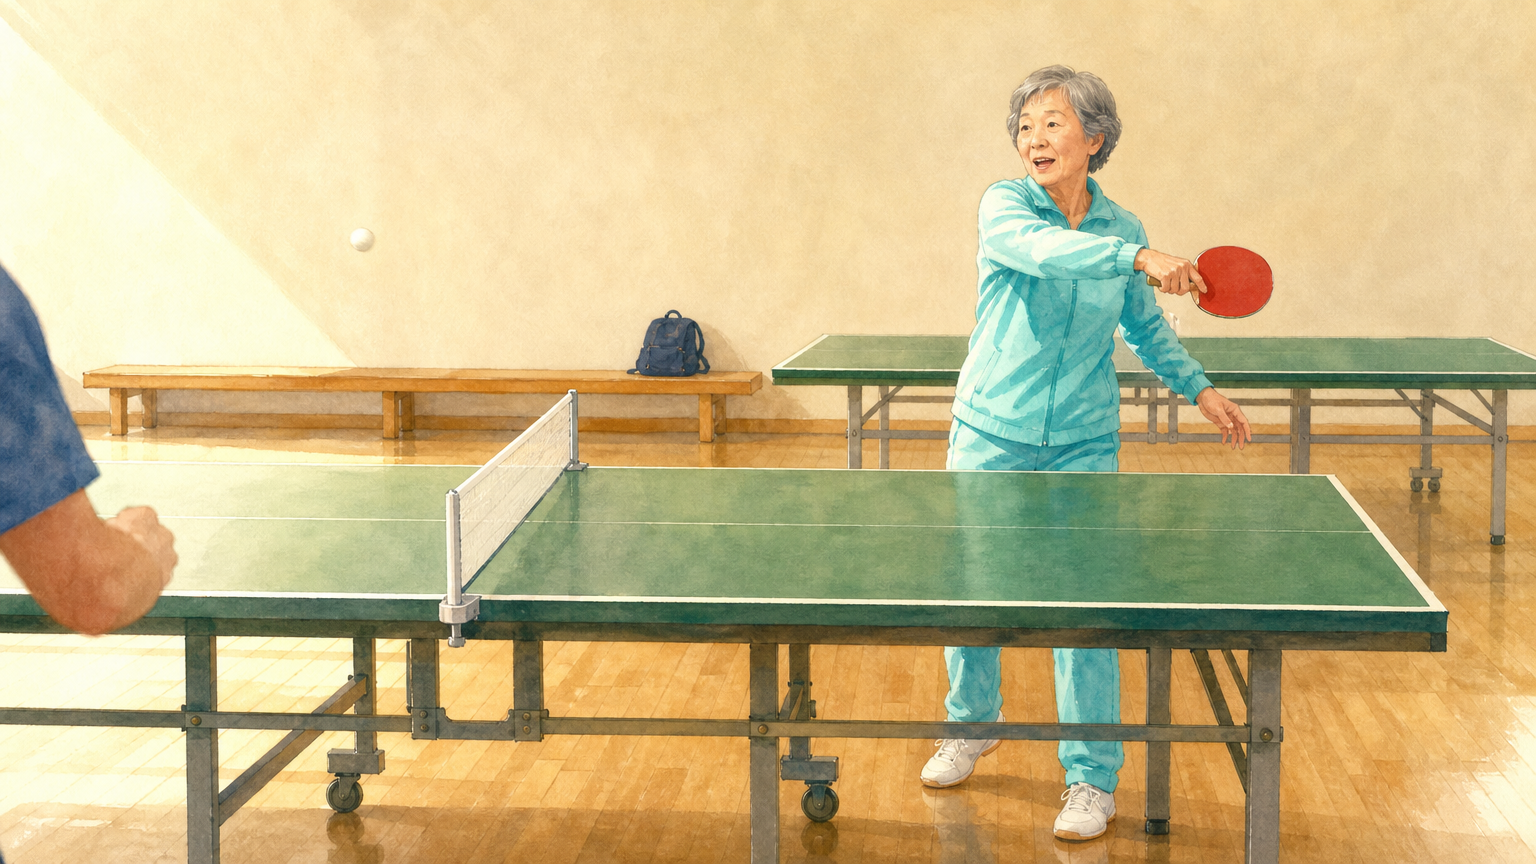
月曜の十二時すぎ、市民体育館の二階の卓球室で、台の下に転がった球を拾おうとしゃがんだとき、壁ぎわのベンチに置いたリュックの中で、携帯が短く震えた。
このサークルに通うようになって、三か月になる。月曜は僕の休みで、平日の昼に打てる場所を探していたら、ここに行き着いた。台は四つあり、僕のほかは、僕の親より年上の人ばかりだ。球は白とオレンジが混ざっていて、誰も色をそろえようとしない。
相手はたいてい河野さんで、河野さんは打ちながら話す。球が台の上を行き来しているあいだに、今朝のスーパーの卵の値段や、去年替えた眼鏡の度の話をして、僕の返事を待たずに次の球を返してくる。僕が「そうなんですか」と言いかけると、その上にもう次の話がかぶさっている。
「五分、休憩ね」と世話役の森さんが手を叩いた。
ベンチで水筒のふたを開けて、携帯を見る。届いていたのは、Shizuku AIという日本の会社の記事だった。「しずく」というAIのキャラクターを作っている会社が、十一月八日に自分たちのブログで、日本語の音声対話のモデル「Shizuku-Duplex」を作ったと書いている。相手の話を聞きながら、同時に話せる。だから相づちを打てるし、相手が言い終わる前に返事を始められる。話し終わってから返事が始まるまでは、会社が自分で測ったところで〇・五七秒。難しい調べものは裏にいる別のモデルに任せて、そのあいだも受け答えを続けるのだという。
いつから、どこで話せるのかは、下までたどっても書いていなかった。あるのは、会話の様子を撮った動画だけだ。
「何を熱心に読んでるの」隣に腰を下ろした河野さんが、タオルで首を拭いた。
「話を聞きながら話すAIが、できたらしいんです。相づちも打つって」
「へえ。それ、球も打つの」
「打たないと思います」
「じゃあ、まだ半人前ね」河野さんはタオルをたたんで膝にのせた。「打ちながら話すのはね、話すことを、返す前に決めておくの。決めないで待ってると、球も話も、両方落とすから」
「どこで話せるのかも、まだ書いてないんです」
「なら今日のところは、私で我慢しなさい」
森さんが、もう一度手を叩いた。
休憩のあとは、河野さんと田辺さんが台についた。田辺さんは毎週、同じ紺のポロシャツで来る。二人は打ち合いながら、来月の市の大会の話を始めた。
僕はベンチから二人を見ていた。田辺さんが膝の具合を話しているうちに、河野さんはもう、大会の日の弁当の話をしている。声はしょっちゅう重なるのに、どちらも止まらない。球も止まらない。ラリーの音と話し声が、同じ速さで台の上を行き来していた。
途中で田辺さんが、申し込みの締め切りはいつだったかと聞いた。河野さんは球を返しながら、ベンチのほうへ顔を半分向けた。「森さん、締め切り、いつだっけ」。森さんが鞄から回覧の紙を出して老眼鏡をかけるあいだも、二人のラリーは続く。話も、田辺さんの膝から湿布の貼り方へ移っていた。縦に一枚、横に一枚。
「二十日。金曜」と森さんが読み上げると、河野さんは「二十日だって」と返しながら、台の角に球を落とした。田辺さんは取れなかった。
「湿布はね、貼るより剥がすほうが大事なんだよ」と、球を拾いに行きながら、田辺さんが誰にともなく言った。
僕は、〇・五七秒がどれくらいなのかを、二人の球で測ってみようとした。台で一度弾んでから相手のラケットに届くまでが、そのくらいにも、もっと短くにも見える。三か月のあいだ、僕は打ちながら一つの文を最後まで言えたことがない。話そうとすると、僕の球は決まってネットにかかった。
最後の十分で、河野さんがまた僕の相手をしてくれた。
ラリーが続いて、八回目あたりで、僕は返しながら口を開いた。「来週は」と言いかけたところへ、河野さんの声がかぶさってくる。「来週も来るわね。卵が安かったら、買っといてあげる」
球はネットを越えて、河野さんのラケットへ戻っていった。何を言うつもりだったのか、僕はまだ決めていなかった。ラリーは十一回目で、僕が台の外へ打ち出して終わりになった。
更衣室で着替えて階段を下りながら、来週は、返す前に話すことを一つだけ決めておこうと思った。卵の話の続きでもいい。
階段の上で、誰かの打った球の音が、二つ続けて鳴った。
Shizuku AI、聞きながら話して相づちも打つ日本語の音声対話モデル「Shizuku-Duplex」を開発
日本のスタートアップShizuku AIは2026年11月8日(日)、80ミリ秒ごとに相手の声を聞きながら自分の声を出す日本語の音声対話モデル「Shizuku-Duplex」を開発したと、同社のブログで発表した。相手の話を聞きながら話せるFull-Duplex (全二重) の方式で、相づちを打ち、話し終わりを待たずに返事を始める。同社の測定では、話し終わりから返事までの時間は中央値0.57秒。難しい調べものはWeb検索などを使える裏の別モデルに任せ、会話を担うモデルは待つあいだも受け答えを続ける。約5分ごとに会話を要約して作り直し、長い会話でも応答が崩れないようにしている。評価は同社が自作した日本語のベンチマークによるもので、内容の採点はClaude Opus 5.5が行った。ブログには会話のデモ動画が載っているが、一般の人が話せる時期や方法、料金は書かれていない。
運営: AI Quotidia 編集部
海外 AI ニュースを毎朝、日本語で解説する個人運営メディアです。記事は AI を活用して作成し、人手による確認・編集を経て公開しています。