「神Excel」がAIやシステムに読めるかを100点満点で採点。デジタル庁がツール「Harunobu」を紹介
「神Excel」がAIやシステムに読めるかを100点満点で採点。デジタル庁がツール「Harunobu」を紹介【2026年10月】
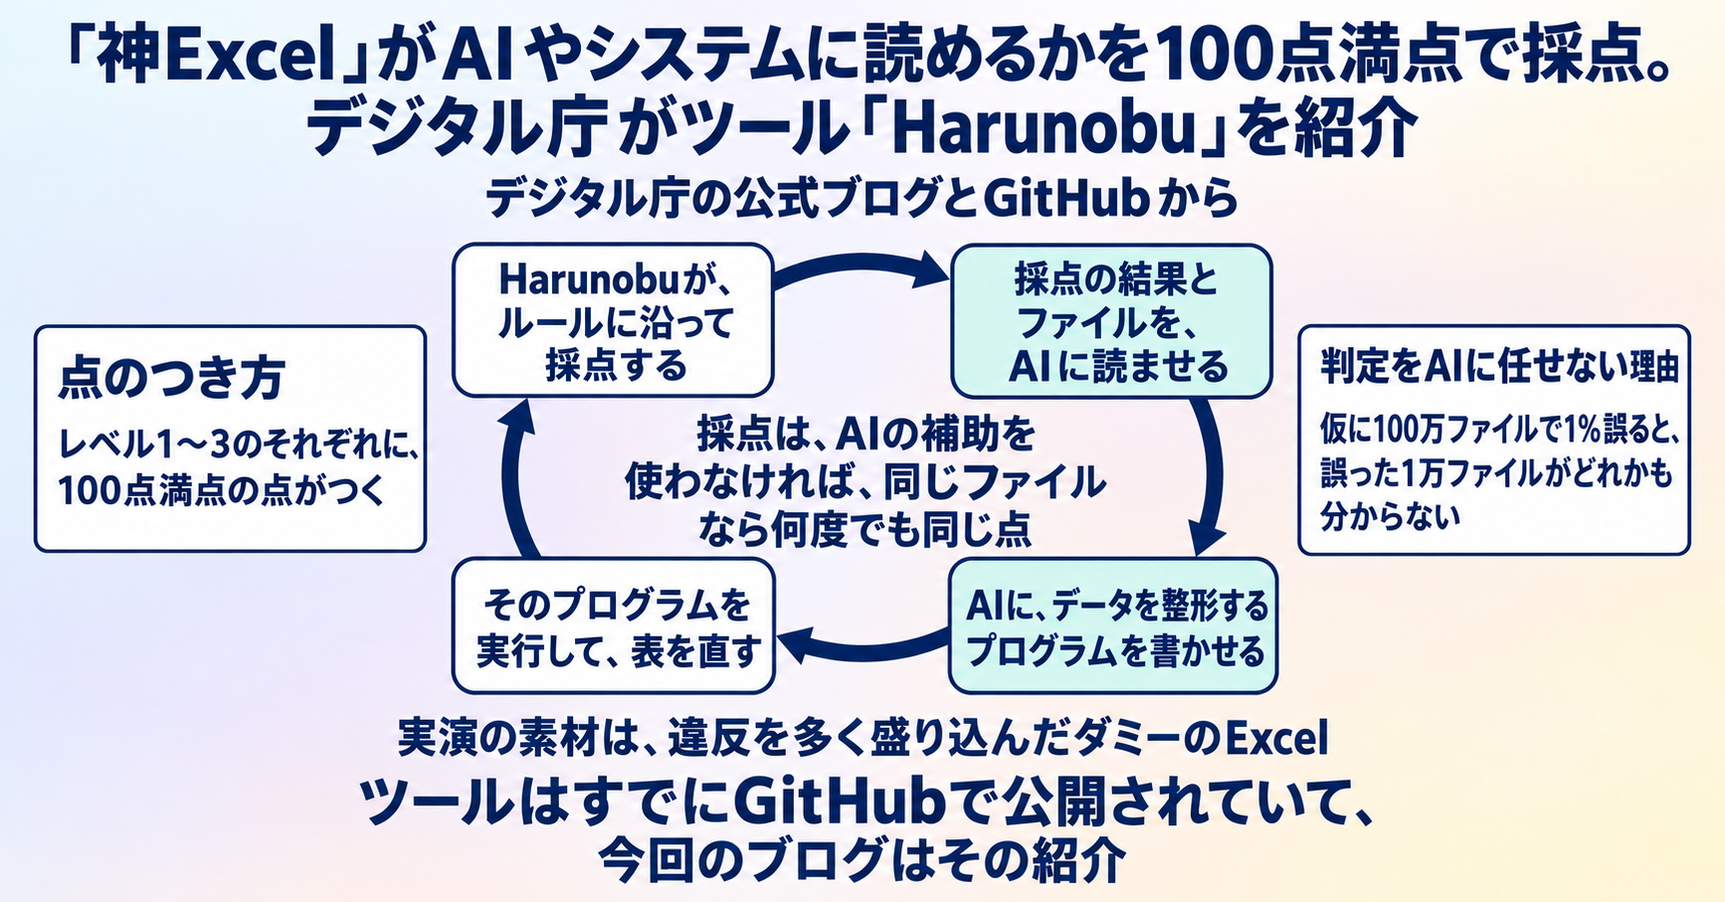
デジタル庁は2026年10月21日(水)、公式ブログで、ExcelやCSVの表の機械可読性を、行政のルールに沿って100点満点で採点するツール「Harunobu」を紹介しました。機械可読性とは、システムやAIが表を正しく読み取れるかどうかの度合いです。印刷したときの見た目を優先して、セルの結合や方眼紙のような配置を多用したExcelは「神Excel」と呼ばれ、人には読みやすくても、機械には読みにくいことがあります。Harunobuの採点はルールで決める仕組みで、オプションのAIの補助を使わなければ、同じファイルなら何度採点しても同じ点になります。ツールはすでにGitHubで公開されていて (最初の版 v0.1.0 は2026年7月27日(月))、今回のブログでは、デジタル庁のデータエンジニアがその考え方と使い方を解説しています。採点結果をもとにChatGPTに「データを整形するプログラム」を作らせる手順も、見本のExcelで実演しました。
この記事のポイント
- 採点の物差しは、2026年3月31日(火)に決まった「行政データにおける機械可読性に関するルール」。レベル1〜3の3段階で、点はレベルごとに出る
- 判定はルールに沿って決める仕組みで、AIに任せていない。理由は、AIに判定させた場合の誤りを、100万ファイル・誤り1%という仮定の数字で説明している
- AIでの補助はオプション。オンにしたときだけ、利用者が設定した外部のAIサービスにデータが送られる
- 表を直す作業では、AIに直接直させず、AIに書かせたプログラムで直す手順を示した
- ツールはデジタル庁のエンジニアによる「完全内製」で、ルールを完全に反映した公式のものではなく「あくまで一例」と同庁は書いている
「神Excel」の何が、機械には読みにくいのか
ブログは、紙に印刷したときにきれいに見えるよう、セルを結合したり方眼紙のように配置したりしたExcelについて、「データ活用を行うシステムやAIにとって使いやすいとは限りません」と書いています。ブログによると、人が見て分かりやすいようにしたセルの結合や項目の省略が、システムにとってはデータの読み間違いを引き起こす原因になることがあります。
採点の基準になっているのは、2026年3月31日(火)に決定された「行政データにおける機械可読性に関するルール」です。対象は、国の行政機関が今後作成するテーブルデータ (オープンデータ) です。オープンデータとは、国や自治体が、誰でも使えるように公開しているデータのことです。ルールは機械可読性を3つのレベルに分けています。
| レベル | できること |
|---|---|
| レベル1 | 閲覧・転記が可能 |
| レベル2 | 集計・分析が可能 |
| レベル3 | 連携・自動化が可能 |
レベル1の例として、次のような決まりが挙がっています。
- セルの結合をしない
- 1つのセルに1つのデータを入れる
- スペースや改行で体裁を整えない
- 書式でデータの違いを表現しない
- 1つのシートに複数の表を載せない
今後公表するオープンデータは「これらレベル1の基本的なルールを少なくとも満たすよう、取り組んでいくこととされています」とブログは書いています。すでにあるデータを直すことについては、大きなコストがかかるとしています。
Harunobuは、どう採点するのか
HarunobuはExcel・CSV・TSVのファイルを読み込み、レベルごとに100点満点で採点します。GitHubの説明 (README) に載っている出力の例は「レベル1で100点、レベル2で40点、レベル3で0点」で、点はレベルの数だけ並びます。違反は重さによってFATAL・CRITICAL・MAJOR・MINORの4段階に分けて配点されます。
結果は、どのセルがどのルールに反したかまでJSON形式で出力されます。画面 (WebUI) の判定結果では、セルごとに「L1-02」「L3-01」のようなルールの番号が付きます。表のどこを直せばよいかが、セルの単位で分かる作りです。
名前は浮世絵師の鈴木春信にちなみます。デジタル庁の説明では、神Excelという紙に、複数のルールという版を重ねて、機械可読なデータという浮世絵を刷る、という見立てです。
なぜ、判定をAIに任せないのか
Harunobuの判定は「ルールベースの決定論的な」ロジックです。決定論的とは、入力が同じなら何度やっても答えが変わらないことで、ブログは100回採点すれば100回とも一致すると説明しています。AIに判定させると、答えが毎回そろうとは限りません。
デジタル庁は、その差を次の計算で示しました。「仮に100万ファイルを判定させて1%の確率で誤判定が起こったとすると、1万ファイルは間違った判定結果となり、またその間違ったファイルがどれだかわからない」。ブログ自身が「仮に」と前置きしている、たとえとしての計算です。ブログはこの計算に続けて、Harunobuの開発では「判定結果を完全に再現できること」を重視したと書いています。
AIを補助に使って精度を上げる機能もありますが、ブログは「あくまでオプション」としています。オンにした場合に限り、利用者が自分で設定した外部のAIサービス (Gemini・ChatGPT・Claudeなど) のAPIにデータが送られます。オフなら手元の環境で動き、ファイルの中身は外部に送られません。
表を直す作業では、AIをどう使うのか
ブログが示した手順は5段階です。
- Harunobuで判定する
- 判定結果とファイルをAIに読ませる
- AIに「データを整形するプログラム」を作らせる
- そのプログラムを実行する
- 結果を検証し、必要なら1に戻る
ブログが「重要」としているのは3つ目です。AIに直接データを直させるのではなく、毎回同じ結果を出すプログラムを間に置きます。直した表はもう一度Harunobuにかけられるので、点が上がったかどうかを同じ物差しで確かめられます。
実演には、執筆時点 (2026年10月) で無料で使えるChatGPT (モデルはGPT-5.6 Luna) を使っています。素材は実際の行政データではなく、ルール違反を多く盛り込んで作ったダミーのExcelです。加工の前は、セルを結合した見出し、空行、注記、「〃」の入った表でした。加工の後は、年月・都道府県コード・市区町村コード・値・状態の列が並ぶ縦長の表に変わっています。ブログは、外部の生成AIサービスでデータを扱う場合は「所属組織の利用ルールに従って」ほしいとも書いています。
Harunobuが見ていないもの
デジタル庁は、Harunobuの実装を「機械可読性ルールを完全に反映した公式のものではなく、あくまで一例」としています。コード表があるかどうか、データの定義や更新履歴は、判定の対象に入っていません。「データ本体と無関係な情報がないか」といった項目も、意味を読み取って判定するのではなく、データの範囲の外にあるタイトルや注釈を機械的に見つける方式です。
まとめ(FAQ)
Q. デジタル庁が新しいツールを出したのですか?
A. HarunobuはすでにGitHubで公開されていて、最初の版 v0.1.0 は2026年7月27日(月)にリリースされています。2026年10月21日(水)のブログは、その考え方と使い方を紹介したものです。最新の版は2026年10月22日(木)に出たv0.2.2です。
Q. AIがExcelを採点するのですか?
A. 採点はルールに沿って決める仕組みで、同じファイルなら毎回同じ点が出ます。AIはオプションの補助として使えるほか、ブログの手順では、直すためのプログラムを作る段階でChatGPTを使っています。
Q. 「1%誤ると1万ファイル」は、AIの実際の誤り率ですか?
A. ブログが「仮に」と前置きした計算です。ブログには、AIの判定の誤り率を測った数字は示されていません。
Q. 役所のExcelは、これから全部読みやすくなるのですか?
A. ルールが対象にしているのは、国の行政機関が今後作るオープンデータです。レベル1を少なくとも満たすよう「取り組んでいく」という段階で、すでにあるデータの見直しには大きなコストがかかるとされています。
検証メモ(出典と確認の範囲)
- デジタル庁の公式ブログ (note)「Excel の機械可読性を判定するツール『Harunobu』のご紹介」(2026年10月21日(水)・筆者はデジタル庁ファクト&データユニットのデータエンジニア 長谷川亮氏) のHTML原文と、掲載の画像8点のうち3点 (ルールの概要表 / WebUIの判定結果の例 / ChatGPTで加工した前後の比較) によります。
- デジタル庁の解説ページ「機械可読性ルール適合チェックツール『Harunobu』」(冒頭から利用形態まで) と、GitHubのリポジトリ (digital-go-jp/machine_readability_rule) のREADME・コミット履歴・リリースを確認しました。最初のコミットは2026年6月17日(水) (公開を確認できる最も早い記録は2026年8月28日(金))、v0.1.0のリリースは2026年7月27日(月)、最新のv0.2.2は2026年10月22日(木)です。
- 「1%」「1万ファイル」はブログの仮定の計算です。
- ルール本体のPDF、ルールごとの配点表 (CSV)、GitHub上の制限事項のガイドは確認していません。
- 2026年10月23日(金) 時点の確認による情報です。
Quotidia の視点
Harunobuの手順は、AIに任せる仕事の切り方がはっきりしている。点をつけるのはルール、表を直すのはプログラムで、AIが受け持つのは、そのプログラムを書く部分になっている。ChatGPTに表を渡して「きれいにして」と頼めば、整った表が返ってくることもあるだろう。ただ、どのセルをどう動かしたのかは、返ってきた表と元の表を見比べて確かめるしかない。プログラムを間に置けば、同じ形の表には毎回同じ処理がかかり、直した結果をHarunobuでもう一度採点できる。デジタル庁のルールは、国の行政機関がこれから公表するオープンデータについて、レベル1を満たすよう取り組むことを求めている段階で、紙の見た目に合わせて作られてきた表が、それで一度に入れ替わるわけではない。それでも、手順のほうは役所の表に限らない。外部のAIサービスにデータを渡してよいかは所属先の決まりに従うよう、ブログ自身が断っているが、その決まりの内側でなら、毎月同じ様式で届く集計表を整える仕事にも、この順番は持ち込める。
関連記事:
- 『企業AIエージェントの9割が本番に届かない』は本当か。よく見る数字に、確たる出所はなかった【2026年6月】(「企業のAIエージェントの9割が本番に届かない」という数字を検証した回。AIに渡す前のデータの整い方が、AIを実際の仕事で使えるかを左右するという点で近い。今回のデジタル庁のブログは、その手前の表の形を、ルールで採点するところから始めている)
二番クラリネットの清書
楽譜係の仕事の半分は、消しゴムでできている。残りの半分は鉛筆で、そのさらに半分は、人の字を読むことに使われる。
僕たちの市民吹奏楽団は、日曜の午前、駅の北にある中学校の音楽室を借りて練習している。九時に始まるので、椅子を並べる当番の日は八時四十分に着く。その日曜も当番で、音楽室に入ると、楽譜係の三宅さんがもう教卓に座っていた。右手のガラスから入る光が、積み上げたパート譜の端を白くしていた。
三宅さんは二十六歳で、楽団では僕より二年先輩にあたる。次の演奏会の曲のパート譜を、彼女は一枚ずつ新しい五線紙に清書していた。前の演奏会で使った紙には、吸う場所の印や、指揮者の口癖のメモや、誰かが書いて誰かが消しかけた矢印が重なっている。そのままでは、次にその席に座る人が読めない。
「金曜にね、課長が全員にリンクを回してきたの」と、彼女は二番クラリネットの譜面から目を上げずに言った。
回ってきたのは、デジタル庁が公式のブログで紹介した「Harunobu」というツールの記事だった。ExcelやCSVで作った表を、AIやシステムがきちんと読み取れるかどうか、国のルールに沿って百点満点で採点する。彼女の話では、勤め先の出張申請書はセルを結合して方眼紙のように升目をそろえてあり、印刷すると見栄えがいい。ただ、そういう表は、AIやシステムに読ませると、うまく読み取れないことがある。
「点をつけるのはルールで、AIじゃないんだって。百回採点したら、百回同じ点が出る」と三宅さんは言った。「AIに判定させて、百万のファイルで一パーセント間違えたら、一万のファイルが間違いになる。しかも、どれが間違いなのか分からない。たとえばの計算だけどね、って書いてあった」
「うちの申請書は、何点だったの」
「怖くて、まだ入れてない」
彼女は消しゴムを置いて、鉛筆を持ち替えた。
「書き込みはね、書いた人の記憶と組になって、はじめて読めるの。記憶のほうは、楽譜と一緒に次の人に回ってこない」
教卓の脇の床に、消しゴムのかすが小さな山になっていた。
二番クラリネットの清書が終わると、三宅さんは譜めくりの位置に、鉛筆で小さな印をつけた。四小節の休みがあるところで、ページが変わるようにしてある。前の紙では、十六分音符が続く途中でめくることになっていて、演奏会の本番で、二番の二人がそろって一小節を落とした。
「直すほうの話もあってね」と彼女は言った。「表をAIに渡して、直して、って頼むんじゃないの。直すためのプログラムをChatGPTに書かせて、そのプログラムに直させる。そうすれば、何度やっても同じように直る。直したら、またHarunobuで採点する」
「それは、課長が自分でやるの」
「やらない。たぶん私」と三宅さんは言った。「それに、ブログで直してたのは、わざと崩して作った見本のExcelだったし、ツール自体は前から公開されてたの。課長が見つけたのが、今週だったっていうだけ」
それから彼女は、紙の束の中から、僕のトロンボーンのパート譜を抜き出した。三ページ目の余白に、僕の字で「ここで吸う」と書いてある。その横に矢印が三本と、丸で囲んだ「急がない」と、何のためにつけたのか思い出せないVの字が二つある。
「どれが要るの」
鉛筆を借りて、矢印を二本と、Vの字を二つとも消した。「ここで吸う」と「急がない」は残し、ほかの人にも読めるように、楷書で書き直した。書きながら、自分の字がこんなに右に傾いていたことを、はじめて知った。
三ページ目のいちばん下の余白には、もう一つ、鉛筆で描いた小さな猫がいた。耳が片方だけ長い。いつから余白にいるのか、三宅さんも知らないという。
「それも消す?」と僕は聞いた。
「それは残す」と彼女は言った。「点数には入らないから」
黒板の隅には、中学生の字で「合唱コンクールまで あと十二日」と書いてあった。借りている側は、黒板には手を触れない取り決めになっている。
九時の十分前に、団員が一人ずつ入ってきて、楽器のケースの留め金を外す音が、音楽室のあちこちで鳴った。三宅さんは清書の済んだパート譜を、席の順に譜面台へ配っていった。廊下のほうで、誰かがチューニングのB♭を、長く、低く吹きはじめた。
デジタル庁、Excelの機械可読性を100点満点で採点するツール「Harunobu」を公式ブログで紹介。判定はルールベースでAIに任せず
デジタル庁は2026年10月21日(水)、公式ブログで、Excel・CSV・TSVがシステムやAIにとって読み取りやすいかを、2026年3月31日(火)決定の「行政データにおける機械可読性に関するルール」に沿って採点するツール「Harunobu」を紹介した。点はレベル1 (閲覧・転記可能)・レベル2 (集計・分析可能)・レベル3 (連携・自動化可能) ごとに100点満点で出て、どのセルがどのルールに反したかまでJSONで出力される。判定はルールベースの決定論的なロジックで、100回採点すれば100回同じ結果になる。AIに判定させない理由について、同庁は「仮に100万ファイルを判定させて1%の確率で誤判定が起こったとすると、1万ファイルは間違った判定結果となり、またその間違ったファイルがどれだかわからない」と仮定の計算で説明した。AIの補助はオプション。表を直す作業では、AIに直接直させず、ChatGPTに整形プログラムを書かせて実行する手順を、ダミーのExcelで実演した。ツールは同庁のエンジニアによる完全内製で、すでにGitHubで公開されている (最初の版 v0.1.0 は2026年7月27日(月))。ルールの対象は国の行政機関が今後作成するオープンデータ。
運営: AI Quotidia 編集部
海外 AI ニュースを毎朝、日本語で解説する個人運営メディアです。記事は AI を活用して作成し、人手による確認・編集を経て公開しています。