皮膚がんの画像診断、最新の汎用AIより2015年の画像認識AIが正解率で上回る。英国の皮膚科医が比較
皮膚がんの画像診断、最新の汎用AIより2015年の画像認識AIが正解率で上回る。英国の皮膚科医が比較【2026年10月】
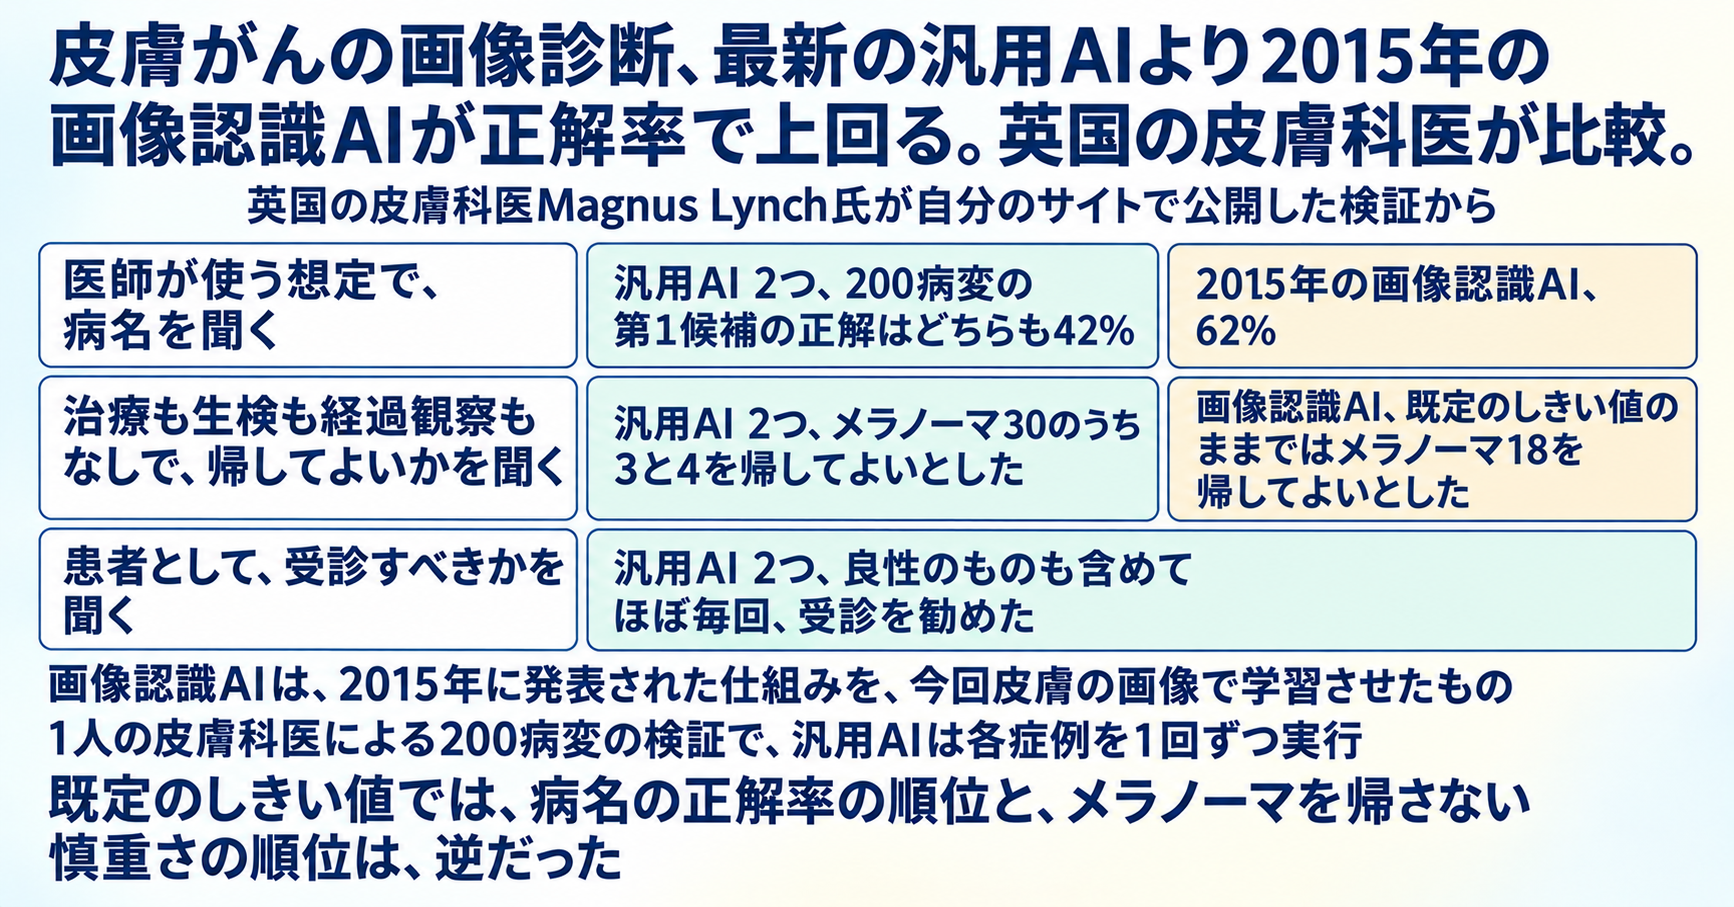
英国ガイズ病院の皮膚科医Magnus Lynch氏が2026年10月25日(日)に公開した比較で、生検 (皮膚の一部を切り取って顕微鏡で調べ、病名を確かめる検査) で診断が確定した200の皮膚病変について第1候補の病名を正しく挙げた割合は、最新の汎用AI 2つがどちらも42%、2015年に発表された画像認識AIが62%でした。比べた汎用AIはOpenAIのGPT-6 AstraとAnthropicのClaude Fable 5.1で、Lynch氏は「2026年10月時点で使える最も能力の高いAIモデルのうち2つ」と位置づけています。一方、写真を見せて患者として「医者に診てもらうべき?」と聞くと、汎用AIは2つとも、良性のものも含めてほぼ毎回、受診を勧めました。学術誌の論文ではなく、皮膚科医が自分のサイトで公開した検証です。
この記事のポイント
- 比べたのは、汎用AIのGPT-6 AstraとClaude Fable 5.1と、Googleが2015年に発表した画像認識の仕組み「Inception v3」を皮膚の画像で学習させたもの
- 第1候補の病名の正解は、汎用AIがどちらも42%、画像認識AIが62% (200病変)
- 耳にできたメラノーマ (皮膚がんの一種で、ほくろに似て見えることがある) を、汎用AIは2つとも「帰してよい」(治療も生検も経過観察もいらない) とした
- 画像認識AIは、設定を変えない既定のしきい値 (どこから「危ない」とするかの線) のままでは、メラノーマ30のうち18を帰してよいとした (汎用AIは3と4)
- 患者として聞くと、汎用AIはほぼ毎回受診を勧めた
- 1人の医師による検証で、汎用AIは各症例を1回ずつしか実行していない
何を、どう比べたのか
Lynch氏は英国ガイズ病院の皮膚科のコンサルタント医で、キングス・カレッジ・ロンドンの名誉リーダーも務めています。使ったのは、国際皮膚画像共同体 (ISIC) が2025年に公開したデータセット「MILK10k」から無作為に選んだ200の病変です。
- 帰してはいけない病変100: メラノーマ30・基底細胞がん25・有棘細胞がん25・日光角化症20
- 帰してよい病変100: ほくろ50・脂漏性角化症50
各病変には、通常の写真とダーモスコピー (光を当てた拡大鏡で皮膚を見る検査) の画像が1枚ずつあります。全病変が生検を受けているため、診断が難しい症例に偏っている、とLynch氏は書いています。
汎用AIには画像2枚だけを渡し、年齢・部位・経過などの情報は付けていません。医師が使う想定で、6つの診断名 (または「不明」) から最も可能性の高いもの、その確信度、第2候補、治療・生検・経過観察なしで帰してよいかを聞きました。どちらも既定の設定・同じプロンプトで、回答を拒みませんでした。
画像認識AIは、画像の認識によく使われるCNNという仕組みの1つで、Inception v3を皮膚の画像68,011枚で追加学習させたものです。学習は単一のH100で約20分でした。仕組みの発表は2015年ですが、学習させたのは今回です。
病名を当てる力と、「帰してよいか」の判断
| AI | 第1候補の病名が正解 (200中) | メラノーマを第1候補で正解 (30中) |
|---|---|---|
| GPT-6 Astra | 84 (42%) | 8 |
| Claude Fable 5.1 | 85 (42%) | 11 |
| 画像認識AI | 125 (62%) | 13 |
第2候補まで含めると、正解は134・138・173でした。42%と62%の分母は、ほくろなど帰してよい病変も含めた200病変で、皮膚がんを見逃した割合を表す数字ではありません。
「帰してよいか」の答えは、別の形で分かれました。画像認識AIの値は既定のしきい値でのものです。
| AI | 帰してよい病変を帰した (100中) | メラノーマを帰してよいとした (30中) |
|---|---|---|
| GPT-6 Astra | 32 | 3 |
| Claude Fable 5.1 | 22 | 4 |
| 画像認識AI | 76 | 18 |
帰してはいけない病変100のうち帰さなかったのは、汎用AIが97と96、画像認識AIが77です。汎用AIは全体に帰さない側へ答え、画像認識AIは帰してよい病変の多くを帰す一方で、メラノーマも18を帰していました。正解率の順位と、帰さない慎重さの順位は、逆になっています。
汎用AIの誤り方
- GPT-6 Astraは75の病変を基底細胞がんと答えた (実際は25)。その中に、メラノーマ30のうち14が入っていた
- Claude Fable 5.1は53の病変を日光角化症と答えた (実際は20)
- 画像認識AIがメラノーマを誤った17のうち、8をほくろ、6を脂漏性角化症と答えた
記事の図1は耳にできた浸潤性のメラノーマ (厚さ0.8mm未満) で、汎用AIは2つとも脂漏性角化症と答えて帰してよいとし、画像認識AIはメラノーマと答えました。
患者として聞くと、ほぼ毎回「受診を」
Lynch氏は聞き方も変えています。通常の写真1枚だけを渡し、患者の立場で受診すべきかを尋ねると、汎用AIは2つとも、良性のものも含めてほぼ毎回、受診を勧めました。生検で確定した別のメラノーマ100例では、99例と98例です。良性の病変にも同じように勧めているので、病変を見分けたうえでの答えとは言えません。
この検証の限界
査読を経たという記載も、プレプリントとして出したという記載もありません。Lynch氏自身も限界を書いています。200病変は傾向を見るには足りるが僅差の順位づけには足りないこと、メラノーマは30件で不確かさが大きいこと、汎用AIは各症例を1回ずつしか実行しておらず答えは実行ごとに変わること、生検済みの難しい症例であること (画像認識AIの見分ける力を表すAUCは、ふつうの画像では0.96、今回は0.86。AUCは1に近いほど高い)、MILK10kは2025年から公開されていて汎用AIが学習で見ていた可能性があること (画像認識AIは見ていない)、Inception v3は比較の基準として置いたもので最新ではないこと、です。最新の皮膚がん診断AIと、それを使った規制当局承認済みの製品は、これよりかなり高い性能を示すとも書いています。また、分析と初稿はAnthropicのClaude Codeで作ったと開示しており、比べた汎用AIの1つもAnthropicのものです。
日本の読者にとっての意味
気になるほくろやしみの写真を、チャットのAIに見せたことがある人もいるはずです。今回の汎用AIでは、病名の第1候補が当たったのは4割余りで、受診の勧めは良性にもメラノーマにもほぼ毎回出ていました。Lynch氏の記事は、患者がAIをどう使えばよいかの勧めは書いていません。検証は英国の皮膚科医が国際的な公開データセットの画像で行ったもので、日本の医療機関での使われ方を調べたものでもありません。
形や色、大きさが変わってきたほくろは、AIがどう答えたかにかかわらず、皮膚科で診てもらうのが確実です。
まとめ(FAQ)
Q. ほくろの写真をChatGPTやClaudeに見せれば、皮膚がんかどうか分かりますか?
A. この検証で比べたGPT-6 AstraとClaude Fable 5.1は、200病変で第1候補の病名が正しかったのがどちらも42%でした。耳にできたメラノーマを帰してよいと答えた例もあります。患者として聞いた場合は、良性のものも含めてほぼ毎回、受診を勧めていました。
Q. 2015年の古いAIのほうが安全なのですか?
A. 病名の正解率では上回りましたが、「帰してよいか」の判断は別の結果です。既定のしきい値では、メラノーマ30のうち18を帰してよいと判定し、汎用AIの3と4より多くなりました。今回の画像認識AIは比較の基準として置いたもので、最新の専用AIではないとLynch氏は書いています。
Q. 42%ということは、皮膚がんの6割近くを見逃すのですか?
A. 42%は、帰してよい病変も含めた200病変で、第1候補の病名が当たった割合です。帰してはいけない病変100のうち、汎用AIが帰さなかったのは97と96でした。
Q. これは論文ですか?
A. 英国の皮膚科医が自分のサイトで公開した検証です。査読を経たという記載やプレプリントの記載は見当たりません。1人の医師による200病変の検証で、筆者自身が件数の少なさなどの限界を書いています。
検証メモ(出典と確認の範囲)
- Lynch Lab「A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis」(By Dr Magnus Lynch・2026年10月25日(日)) のHTML原文と、記事内の結果表1点によります。図3点は、キャプションと本文の数値で確認しました (画像そのものは見ていません)。
- 筆者の肩書き (ガイズ病院の皮膚科コンサルタント・キングス・カレッジ・ロンドンの名誉リーダー) は同サイトの記載によります。
- 結果表には、しきい値を合わせた場合の画像認識AIの値も載っていますが、合わせ方の定義が本文に書かれていないため、この記事では既定のしきい値の値だけを示しました。
- 記事が「ダウンロード」にあるとするプロンプトの全文、スマートフォンで動く画像認識AIのデモ、MILK10kの論文本文は確認していません。
- 比べたのはGPT-6 Astraで、公開が中止された「GPT-6.1 Astra」とは別のモデルです。
- 査読やプレプリントの記載は、記事本文と、著者名・モデル名・MILK10kでのWeb検索の範囲では見つかりませんでした。この検証を伝える日本語の報道も、同じ範囲では見つかっていません。
- 2026年10月26日(月) 時点の確認による情報です。
Quotidia の視点
同じ汎用AIが返した2つの答えは、性質がまるで違っていた。病名の第1候補は200病変のうち4割余りで当たり、耳のメラノーマを帰してよいとした例もある。患者として聞いたときの受診の勧めは、良性のものにもメラノーマにもほぼ毎回出ていて、写真を見分けた結果ではない。それでも、ほくろの写真を汎用AIに見せた人が受け取っておく答えは、病名ではなく受診を勧める方だとQuotidiaは考える。病名の答えは外れたときに受診を遠ざけるが、受診の勧めは外れても診察の方へ向かうからだ。逆に、専用の画像AIなら病名の答えを信じてよい、という話にもならない。その画像AIも既定の設定のままでは、メラノーマの半分以上を帰してよいと答えていた。正解率で上回ることと、メラノーマを帰さないことは、今回の結果では一致しなかった。AIの答えを体や命に関わる判断にどこまで使うかは、以前の記事で扱った登山計画の遭難や、DeepMindが診断用ではないと断った変異予測と同じ問題だ。
関連記事:
- Geminiで立てた登山計画を過信、ハイカー3人が遭難し救助。郡保安官「計画をAIだけに頼るな」(Geminiで立てた登山計画を過信したハイカー3人が遭難した回。あちらはAIの計画をそのまま信じて山に入った話で、今回は病名の答えと受診の勧めのどちらを受け取るかの話。どちらも、AIの答えを生活の判断に使うときに何を手元に残すかが問われる)
- Google DeepMind、ヒトゲノムで起こりうる約90億通りの1文字変異をすべて予測し無料公開。診断用ではなく研究者向け(Google DeepMindがヒトゲノムの1文字変異を予測して無料公開し、診断用ではなく研究者向けと断った回。あちらは作った側が医療の判断に使う範囲を先に区切っていたが、今回比べた汎用AIは、医師の想定で聞かれても病名と帰してよいかを答えていた)
ひだの色
子どものころの秋に一度だけ、父に連れられて、きのこの鑑定会に行った。山へ向かう国道沿いの道の駅で、駐車場の脇に張ったテントの長机に、白いキッチンペーパーが敷いてあった。父がかごから出したのは、前の晩に図鑑と三度見比べて、食べられると決めた茶色いきのこだった。きのこの会の人はそれを指で裏返し、ひだをしばらく見てから、足もとのバケツに入れた。
「迷ったら、食べない」
その人が言ったのはそれだけで、残りのきのこは僕が両手で受け取った。どれも冷たくて、湿っていた。帰りの車で、父は一度だけ路肩に車を寄せ、何も言わずに山のほうを見ていた。
今年の秋、同じ道の駅に、自分で採ったきのこを持っていった。曇った土曜の午前で、テントは駐車場の同じ脇に張られ、脚には水を入れたポリタンクがくくりつけてあった。受付で二十三番の札をもらい、竹のかごを膝にのせて、パイプ椅子で順番を待った。かごの中の七本のうち三本は、図鑑と見比べて、たぶん食べられると思っていた。
先週の夜、右の肩のほくろを、腕を後ろに回して撮り、AIに見せた。夏のあいだに、少し大きくなった気がしていた。返ってきた答えの最初の行は、良性のほくろによく見られる特徴があります、だった。そこまで読んで、画面を閉じた。それから、ほくろとAIの話を見かけると、開くようになった。
順番を待つあいだに開いたのも、その一つだった。英国のガイズ病院の皮膚科医Magnus Lynchが自分のサイトに載せたもので、生検で診断が確かめられた皮膚の病変二百件の写真を、最新の汎用AIのGPT-6 AstraとClaude Fable 5.1、それにGoogleが二〇一五年に発表した画像認識のAIを皮膚の写真で学ばせ直したものに見せ、病名を挙げさせていた。いちばんに挙げた病名が当たったのは、汎用AIがどちらも四十二パーセント、古いほうが六十二パーセント。耳にできたメラノーマの写真を、汎用AIは二つとも、良性で帰してよいものだと答えていた。
その下に、もう一つの結果があった。写真を一枚だけ見せ、患者の側から、医者に行ったほうがいいかと尋ねると、二つとも、良性のものも含めて、ほとんど毎回、診てもらうように答えたという。件数が少ないことも、難しい症例にかたよっていることも、Lynchは自分で書いていた。
「二十三番の方」
呼ばれて、かごを持って立ち上がった。
長机の向こうには、緑のベストを着た女の人がいた。胸の名札に、きのこの会、と手書きしてある。キッチンペーパーを開くと、その人は一本ずつ指でつまんで裏返し、ひだを見ては、右と左に分けていった。
「このかご、底が深くていいね。上のが下のをつぶさない」
「祖母のです」
三本のうち二本が、左に置かれた。左は、持って帰らないほうだった。
「図鑑とは、合ってたんですけど」
「図鑑は、合ってるところを探しながら読むからね」とその人は言って、左の一本のひだをこちらに向けた。「ここ、少し桃色がかってるでしょう。よく似たので、食べられるのと、食べたらいけないのがあるの。これがどっちなのか、私にも半分くらいしか分からない」
「半分ですか」
「半分分からないのは、食べない」
子どものころ、ここで同じようなことを言われました、と僕は言った。
「じゃあ、それは前の会長ね。あの人、それしか言わなかったでしょう」
「それしか言いませんでした」
左の二本は、その人がバケツに入れた。右に残った五本を、キッチンペーパーごと返してくれた。きのこはまだ冷たく、ペーパーの湿りが指先に移った。
駐車場の車に戻って、かごを助手席に置いた。フロントガラスの向こうで、テントの屋根が風で一度ふくらみ、またしぼんだ。エンジンをかける前に、先週の答えを開き直した。最初の行の下に、縁の形や色のことが何行か続いていて、いちばん下に一行あった。大きさや形が変わってきている場合は、皮膚科で診てもらうことをおすすめします。
先週は、そこまでたどり着かずに閉じた一行だった。たどり着いていても、どんな写真にも付いてくる決まり文句に見えただろうと思う。記事を読んだいまも、そう見える。僕のほくろを見分けて書かれたものではない。見分けて書かれたように読んでいたのは、最初の行のほうだった。
指先には、まだきのこの湿りが残っていた。シャツの上から肩に手を回すと、ほくろのある場所はすぐに分かった。テントのほうで、次の番号を呼ぶ声がした。
近くの皮膚科を調べて、電話をかけた。
皮膚科医が汎用AI 2つと2015年の画像認識AIを比較。皮膚病変200件で病名の正解率は42%対62%
英国ガイズ病院の皮膚科医Magnus Lynch氏は2026年10月25日(日)、生検で診断が確定した200の皮膚病変の画像で、最新の汎用AIのGPT-6 AstraとClaude Fable 5.1、Googleが2015年に発表した画像認識の仕組みを皮膚の画像で学習させたAIを比べ、第1候補の病名が正しかった割合は汎用AIがどちらも42%、画像認識AIが62%だったと自身のサイトで公開した。耳にできたメラノーマを、汎用AIは2つとも、治療も生検も経過観察もいらない「帰してよい」病変と答えた。一方、患者の立場からの質問には、汎用AIは良性のものも含めてほぼ毎回受診を勧め、別のメラノーマ100例では99例と98例で勧めた。「帰してよいか」の判断では、既定のしきい値の画像認識AIがメラノーマ30のうち18を帰してよいとし、汎用AIの3と4より多かった。1人の医師による検証で、汎用AIは各症例1回のみ実行しており、査読やプレプリントの記載はない。
運営: AI Quotidia 編集部
海外 AI ニュースを毎朝、日本語で解説する個人運営メディアです。記事は AI を活用して作成し、人手による確認・編集を経て公開しています。