「検索には載ったまま、AI学習だけ断る」設定、Cloudflareが全プラン無料で提供。Google・Appleのボットに適用
「検索には載ったまま、AI学習だけ断る」設定、Cloudflareが全プラン無料で提供。Google・Appleのボットに適用【2026年9月】
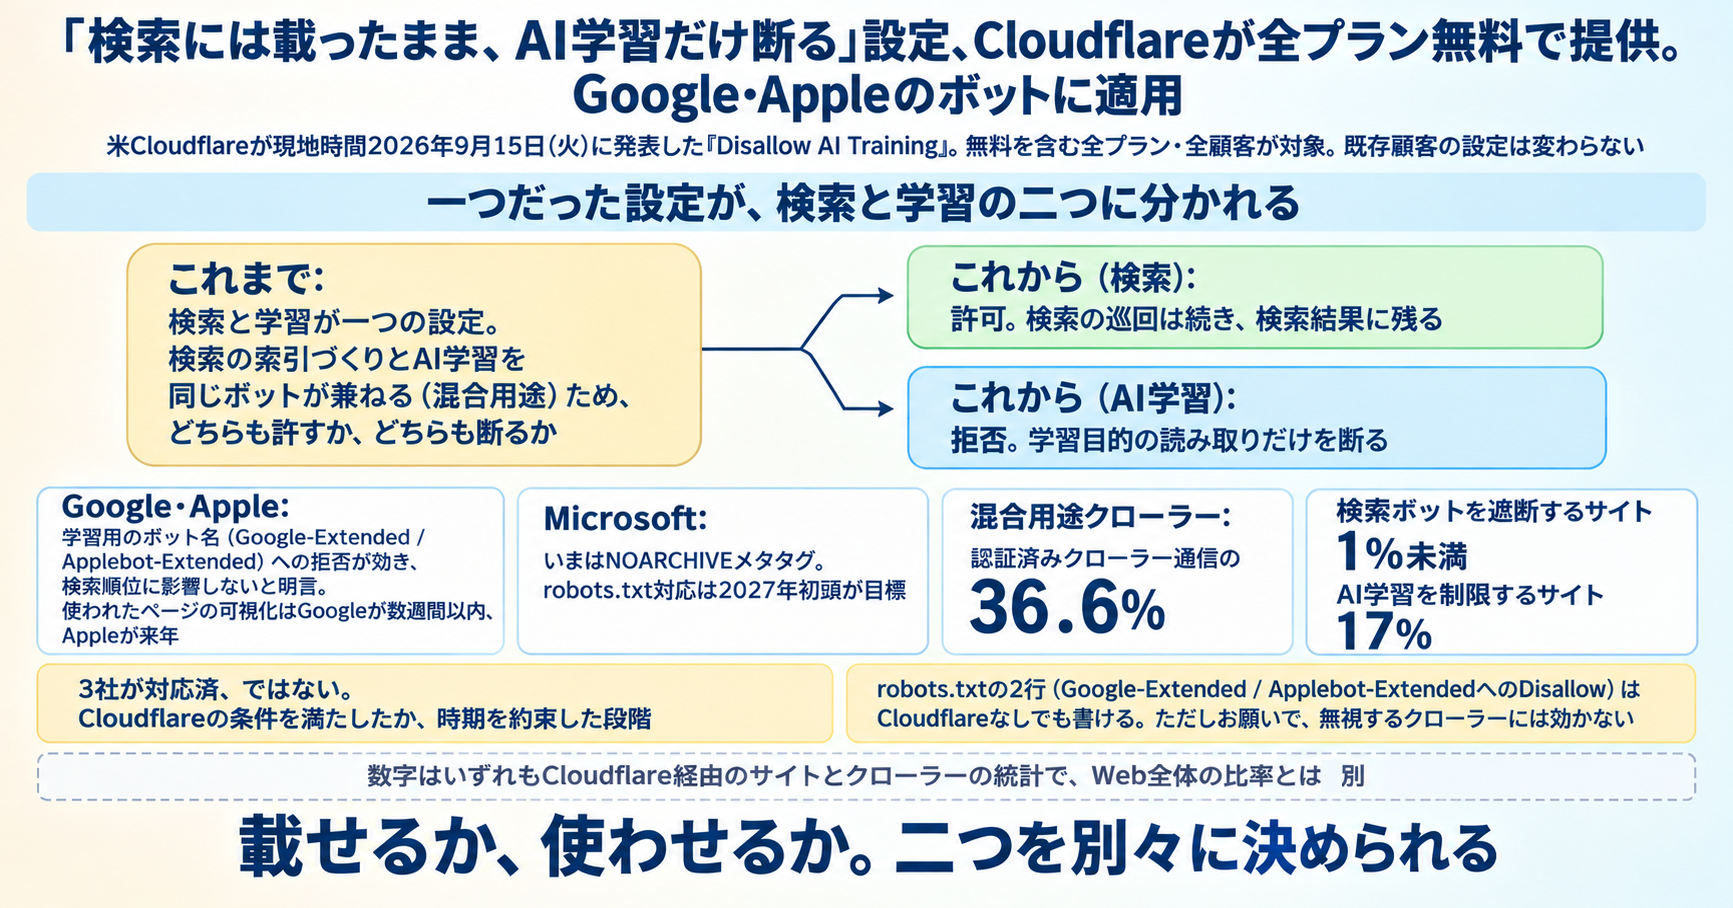
米Cloudflareが、Webサイトを検索結果に残したまま、AIの学習に使われることだけを断れる設定「Disallow AI Training」を発表しました。無料を含む全プランの全顧客に提供されます (現地時間2026年9月15日(火)・同社プレスリリースと公式ブログ)。背景にあるのは、検索の索引づくりとAIの学習データ集めを同じボットで行う「混合用途クローラー」で、Cloudflare上の認証済みクローラー (Cloudflareに身元を登録した正規のボット) の通信量の36.6%を占める、と同社は説明しています。
これまでサイトの運営者は、学習を断ろうとすると検索の巡回まで断ることになり、検索に出たければ学習も許すしかない、という二択を抱えていました。今回の設定はその二択をほどくもので、GoogleとAppleは学習専用のボット名を指定して断れ、Microsoftはrobots.txt (サイトの入口に置く小さなテキストで、どのクローラーに何を許すかを書く) への対応を2027年初頭の目標としています。数字と各社の時期を、発表の範囲で確かめます。
この記事のポイント
- Cloudflareが「Disallow AI Training」設定を発表。検索結果に残ったままAI学習だけを拒否でき、無料を含む全プラン・全顧客が対象 (現地時間2026年9月15日(火))
- 混合用途クローラーは認証済みクローラー通信の36.6%。検索と学習を一台で兼ねるため、片方を断ると両方を断ることになっていた (同社発表)
- 検索ボットを遮断するサイトは1%未満、AI学習を何らかの方法で制限するサイトは17% (Cloudflare経由のサイトの統計)
- GoogleとAppleは学習用の名前 (Google-Extended / Applebot-Extended) への拒否が効く。URL単位の可視化ツールはGoogleが数週間以内、Appleが来年。Microsoftはrobots.txt対応を2027年初頭目標
- 既存顧客の設定はそのまま。新規ドメインには広告の有無で2種類の既定値が入る
何が起きたのか
Cloudflareは、Webサイトの手前に立って通信を中継する会社です。同社を通るサイトの運営者は、管理画面で「Disallow AI Training」を有効にすると、検索エンジンのクローラー (Webページを自動で巡回して読む仕組み。検索の索引づくりやAIの学習データ集めに使われる) には従来どおりページを読ませつつ、AIの学習に使う目的での読み取りだけを断れます。
仕組みの中身は、robots.txtの代筆です。GoogleとAppleは、検索用のボットとは別に、Google-Extended / Applebot-Extended (GoogleとAppleが用意するAI学習用のボット名) を以前から用意しています。Cloudflareは、この名前への拒否を運営者に代わってまとめて設定します。
同社CEOのMatthew Prince氏はプレスリリースで、検索を価値あるものにしている開放性を保ちながら、Webの背後にいる人と企業に、自分の仕事がどう使われるかについての実質的な制御を渡す、という趣旨を述べています。
検索と学習を一台で兼ねる「混合用途クローラー」が36.6%
混合用途クローラー (検索の索引づくりとAIの学習データ集めを一つのボットで兼ねる運用。片方だけ断ることができなかった) は、Cloudflare上の認証済みクローラーの通信量の36.6%を占める、と同社はプレスリリースで説明しています。検索に出るための巡回と、学習のための読み取りが一台のボットに同居していて、片方だけを断る書き方がありませんでした。
運営者の側の現状も、同社のブログに数字があります。検索ボットを遮断しているサイトは1%未満、AI学習を何らかの方法で制限しているサイトは17%です。検索の入口を閉じるサイトはごく少なく、学習を制限しているサイトが一定数あります。
同社のブログによると、OpenAI・Anthropic・Meta・Amazonは検索用と学習用のクローラーが分かれているため、この設定はそれらの学習用ボットだけを遮断する形になります (ITmedia AI+ 2026年9月17日(木) も同旨)。混合用途にあたるのは、Apple・Google・Microsoftの型です。
Apple・Google・Microsoft、それぞれの段階
Cloudflareは、混合用途クローラーの運営者に「説明責任がある (Accountable)」と呼べる条件を4つ挙げています。(1) robots.txtなどでAI学習をオプトアウトできること、(2) 検索結果の上に出るAI要約からのオプトアウトを運営者と直接設定できること、(3) どのページが学習に使われたかのURL単位の可視性と、検索での表示指標、(4) 学習のオプトアウトが従来の検索結果に影響しないという保証、の4点です。
同社のブログによる3社の状況は次のとおりです。Appleは、Applebot-Extendedへの拒否で学習を断れ、検索順位に影響しないと明言しており、URL単位の可視化は来年の予定です。Googleは、Google-Extendedのrobots.txtオプトアウトが使え、こちらも検索順位に影響しないと明言しており、URL単位の透明性ツールは数週間以内に出すとしています。Microsoftは現在NOARCHIVEメタタグ (robots.txtがサイトの入口に置く指示なのに対し、ページごとに書く指示) での指定で、robots.txt対応は2027年初頭が目標です。
Cloudflareが「説明責任がある」と呼んだのは、各社が4条件を満たしたこと、または満たす時期を約束したことです。3社そろって完了した段階ではありません。
既定値と、既存サイトの扱い
新規ドメインには、広告の有無で2種類のプリセットが入ります。広告のあるサイトは「検索は許可・AI学習は拒否・広告ページへのAIエージェント (人の代わりにページを操作する自動プログラム) は遮断」、広告のないサイトは「すべて許可」です。既存顧客の設定はそのまま引き継がれる、と同社は書いています。
数字の読み方 (Cloudflare経由の統計と、お願いとしてのrobots.txt)
36.6%、1%未満、17%は、いずれもCloudflareを通るサイトとクローラーの統計で、Web全体の比率とは別のものです。同社は世界の多くのサイトの手前に立っていますが、日本の個人サイトや企業サイトの実態をそのまま示す数字として読むと、ずれが出ます。
もう一つ、この設定が書いているのはrobots.txtの「お願い」です。学習に使わないでほしい、という意思表示を機械が読める形で置くもので、新しい法律や規制ができた話とは別です。守るかどうかはクローラーの側に委ねられており、無視するクローラーには効きません。Cloudflareには認証済みクローラーの識別や遮断の仕組みが別にありますが、robots.txt自体に強制力はない、という前提は今回も同じです。
日本の読者にとっての意味
個人ブログや会社のサイトを持っている人なら、robots.txtに2行を足すだけで、同じ意思表示ができます。Google-ExtendedとApplebot-ExtendedのそれぞれにDisallowを書けば、検索用のGooglebotやApplebotには従来どおり読ませたまま、AI学習用の読み取りだけを断る形になります。Cloudflareを使っていないサイトでも書けるもので、Cloudflareがしているのは、この記述の代筆と一括化です。
書く前に押さえておきたいのは、この2行がお願いであることと、効く相手が限られることです。GoogleとAppleは名前を分けているので2行が意味を持ちますが、Microsoftのrobots.txt対応は2027年初頭が目標で、それまではNOARCHIVEメタタグでの指定になります。検索順位への影響については、GoogleとAppleがともに影響しないと明言し、Cloudflareも4条件の一つにその保証を入れています。どのページが学習に使われたかを確かめる手段は、Googleの数週間以内のツールと、Appleの来年の可視化を待つことになります。
検索で見つけてほしいか、学習に使われてよいか、を運営者が別々に決められるようになりました。両方を許すのも一つの答えで、Cloudflareの広告なしプリセットはそちらを既定値にしています。
まとめ(FAQ)
Q. この設定を有効にすると、AIに読まれなくなりますか?
A. 断れるのは、AIの学習に使う目的での読み取りです。検索の巡回は続きます。検索結果の上に出るAI要約は別の扱いで、いまは各社に直接設定する形です。Cloudflare上で一か所から度合いを決められる仕組みは、来年初頭を目標に準備中としています。
Q. GoogleとAppleは、Cloudflareに従ったのですか?
A. 両社は以前からrobots.txtで学習を断る名前 (Google-Extended / Applebot-Extended) を用意しており、Cloudflareはその記述を一括で設定します。Cloudflareが「説明責任がある」と呼んだのは、両社が4条件を満たしたか、満たす時期を約束したことです。
Q. Microsoftも同じですか?
A. Microsoftのrobots.txt対応は2027年初頭が目標で、現在はNOARCHIVEメタタグでの指定です。
Q. Cloudflareを使っていないサイトはどうすればよいですか?
A. robots.txtにGoogle-ExtendedとApplebot-ExtendedへのDisallowを書けば、AI学習だけを断る意思表示になります。robots.txtはお願いで、無視するクローラーには効きません。
検証メモ(出典と確認の範囲)
- 本記事の数字と各社の状況は、Cloudflareのプレスリリースと公式ブログ (現地時間2026年9月15日(火)・日本時間でも同日夜) に基づきます。36.6%はプレスリリース、1%未満・17%・4条件・3社の時期・既定値・全プラン提供はブログの記載です。
- 36.6%、1%未満、17%はCloudflareを通るサイトとクローラーの統計で、Web全体の比率とは別です。ブログ中の消費者側の数字 (AI要約を読む消費者の割合など) はブログ内に出典の記載を欠くため、本記事の対象外としました。
- OpenAI・Anthropic・Meta・Amazonが検索用と学習用のクローラーを分けているという記述は、Cloudflareの公式ブログによります (ITmedia AI+ 2026年9月17日(木) も同旨)。
- Google・Appleについては、Cloudflareが「4条件を満たした、または満たす時期を約束した」と認定したもので、GoogleのURL単位ツールは「数週間以内」、Appleの可視化は「来年」、Microsoftのrobots.txt対応は「2027年初頭目標」です。
- CEO Matthew Prince氏の発言はプレスリリースの英文をQuotidiaが要約したものです (逐語訳とは別)。
- 日本語では gihyo.jp (2026年9月16日(水))、ITmedia AI+ (2026年9月17日(木))、Real Sound テック (2026年9月17日(木)) が報じており、Cloudflareのプレスリリースにも日本語版があります。一般紙の報道は2026年9月18日(金) 時点で確認していません。
- 日付は日本時間で記載しています。掲載日 (2026年9月21日(月)) 時点の情報です。
Quotidia の視点
検索には出たい、学習には使われたくない、という二つの希望は、これまで同じ一枚の札にしか書けなかった。Cloudflareが火曜日に出したのは、その札を二枚に分ける設定で、無料のプランにも配られた。QuotidiaのサイトはCloudflareの設定画面を使っていないので、手元にあるのはrobots.txtに自分で書く方法だけだ。そして、いまのQuotidiaのrobots.txtは、Google-ExtendedとApplebot-Extendedを含めて、AIのクローラーを明示的に許可している。読まれるために書いている記事を、検索にもAIにも開けている。では二枚に分けるのか。分ける費用はかからないが、分けたあとに検索の順位が動かないかどうかは、GoogleとAppleの「影響しない」という明言と、Cloudflareが4条件に入れた保証を信じる以外に、いまは確かめようがない。確かめる道具は、Googleが数週間以内、Appleが来年と言っている。順番として、道具が来てから札を分けるかどうかを決める。今日の時点では、一枚のまま置いておく。
関連記事:
- 人間向けではない。CloudflareがAI専用ブラウザKitesurfを無料ベータ公開(同じCloudflareが、人ではなくAIエージェント向けの専用ブラウザ「Kitesurf」を無料ベータで出した回。あちらはAIがWebを読む側の道具、今回は読まれる側のサイト運営者に「検索は許す・学習は断る」の札を渡す設定。同じ会社の、読む側と読まれる側の対)
- 「ブログで強い成果」13.9%は調査開始以来の最低。原因はAIではなく「基本の省略」、米Orbit Media 1,042人調査(米Orbit Mediaの調査で「ブログで強い成果」が13.9%と最低になり、原因はAIではなく基本の省略だった回。あちらはブログ運営者の成果の話、今回は同じ運営者が自分のページをAIの学習に使わせるかどうかを検索と切り離して決められるようになった仕組みの話。書く側の成果と、書いたものの扱いの対)
- ChatGPT以降のウェブページ、3分の1超に「AI執筆の兆候」。Pewが英語49万ページを実測した(Pewが英語49万ページを実測し、ChatGPT以降のWebページの3分の1超に「AI執筆の兆候」があった回。あちらはAIが書いたものがWebに増えている話、今回はWebにあるものをAIが学習に持ち帰ることを運営者が断れるようになった話。Webと学習の、出口と入口の対)
模写はお断り
知人の叔母は絵を描く人で、年に一度、駅裏の小さな画廊を十日間借りて、その年に描いた絵を並べる。何年か前、若い客が一枚の絵を二時間かけて写して帰り、翌年、よく似た絵が別の町の喫茶店に掛かっているのを、叔母本人が見つけた。次の年から、入口に札を出した。撮影と模写はお断りします、と。すると客が減った。札を読んで、見るのも遠慮した人がいたらしい。見せなければ写されない。見せなければ、誰にも見られない。叔母はその二択を三年続けて、去年、札の文句を書き直した。
日曜日の午後、僕はその画廊にいた。展示は六日目で、今年の絵は十二枚。ぜんぶ同じ川の同じ橋を、月を変えて描いたものだ。受付の机に叔母の姿はなく、来場者ノートと呼び鈴だけが置いてある。ノートの今日の欄には三人の名前があって、四人目は名前を書かずに、暑い、とだけ書いていた。左手のガラス戸から午後の光が床に長く入り、乾いた紙と油の匂いがした。
書き直した札は、名刺ほどの厚紙で、画鋲一本で入口の脇に留めてある。
ご覧になるのはご自由に。模写はお断りします。絵はがきは一枚二百円です。
僕の隣で、麻の上着の男が、その札を絵より長く読んでいた。四十をいくつか過ぎたくらいの人で、絵を見るときは腕を組み、札を読むときは腕をほどく。
「写真は、どっちなんだろう」と男は言った。
「書いてないですね」
「書いてないなら、遠慮しておく」。それから三月の橋の前に戻って、黙った。「三月のが一番いい。三月は、この川に行ったことがないんだが」
札の前に戻ってきた男が、うちのサイトも先週これにした、と言った。
「Cloudflare ですか」
「無料のほう」
Cloudflare というアメリカの会社が、火曜日に出した設定のことだ。サイトを検索には見せたまま、AI の学習にだけは持って行かせない。無料のプランも含めて、全部の顧客に配られた。検索と学習の巡回を一台のボットでやっている会社があって、Cloudflare を通る認証済みのクローラーの通信のうち、そういう混合用途のものが 36.6% あった。片方を断れば、両方を断ることになる。叔母の三年間と、同じ二択だ。検索の巡回を止めているサイトは百に一つもなく、学習を制限しているサイトは百のうち十七、と Cloudflare は書いている。
Google と Apple は、学習だけを断る robots.txt の書き方を前から持っていて、Cloudflare はそれをまとめて代筆する。どのページが学習に使われたかを見せる道具は、Google が数週間のうちに、Apple が来年。Microsoft は、来年の初めまでに同じ書き方に応じる、と時期を約束した段階だ。
男は札の最後の行を、二百円、と声に出して読んだ。
「マンホールの蓋の写真を載せている」と男は言った。「九年で千四百枚」
「千四百枚」
「町の蓋は九年で三種類しか増えてないから、ほとんどよその町の蓋だ」。上着のポケットから小さな手帳が出てきて、開かれないまま、また戻った。「見に来る人は、千四百枚も見ない。学習するやつは、千四百枚ぜんぶ見る。それでうちの蓋が、どこかの絵に混ざるんだろう。見てもらったのと、持って行かれたのが、同じ勘定に入っているのが変なんだ」
男が札を見たまま言った。「三社とも、もう乗ったんだろう」
「乗ると言った段階です。Microsoft は、来年の初めが目標で」
「じゃあうちの蓋は、来年の初めまで、一社ぶん開けっ放しか」。男はそれを、湯冷ましみたいに温度のない声で言った。蓋の話をするときの声だ。
僕の書いたものも、通りに面した場所に何年ぶんか並んでいる。札は一枚も出していない。検索で誰かが見つけて読んでくれるのはうれしいし、それを断る理由はどこにも見当たらなかった。ただ、持って行かれた分がどこの絵に混ざったかは、叔母が喫茶店で見つけた絵とちがって、自分の目では見つけられない。見つけられないものに札を出すのは、叔母の一年目より少しだけ勇気が要る。二行書けば済む、と分かっていても。
奥の小部屋に、絵はがきの箱があった。十二枚の橋が、月の順に立ててある。箱の脇には去年までの札が裏返しに敷いてあって、撮影と模写はお断りします、の面が下になっていた。
「三月は、行ったことがないんじゃ」
「絵はがきで行く」
男は三月と、行ったことのある七月を一枚ずつ取って、四百円を呼び鈴の横の皿に置いた。皿には先客の硬貨が、二百円ぶん入っていた。
僕は九月の橋を一枚、取った。持ち帰ってよい橋は、二百円だった。
Cloudflareが「Disallow AI Training」設定を発表、検索に残したままAI学習だけ拒否。全プラン無料、混合用途クローラーは36.6%
米Cloudflareは現地時間2026年9月15日(火)、Webサイトを検索結果に残したままAIの学習だけを拒否できる設定「Disallow AI Training」を発表した。無料を含む全プランの全顧客に提供する。同社によると、検索の索引づくりとAI学習を一台で兼ねる混合用途クローラーは、Cloudflare上の認証済みクローラー通信の36.6%を占め、片方を断ると両方を断ることになっていた。同社ブログによると、検索ボットを遮断するサイトは1%未満、AI学習を何らかの方法で制限するサイトは17%。混合用途クローラーの運営者に求める「説明責任」の条件は4つで、robots.txt等での学習オプトアウト、AI要約からのオプトアウトの直接設定、URL単位の可視性と検索表示指標、学習オプトアウトが検索結果に影響しない保証である。AppleはApplebot-Extendedへの拒否で学習を断れ、検索順位に影響しないと明言し、URL単位の可視化は来年。GoogleはGoogle-Extendedのrobots.txtオプトアウトが使え、検索順位に影響しないと明言し、URL単位の透明性ツールは数週間以内。Microsoftは現在NOARCHIVEメタタグで、robots.txt対応は2027年初頭が目標である。新規ドメインには広告の有無で2種類の既定値 (広告あり = 検索許可・AI学習拒否・広告ページのAIエージェント遮断 / 広告なし = すべて許可) が入り、既存顧客の設定は変わらない。同社ブログによると、OpenAI・Anthropic・Meta・Amazonは検索用と学習用のクローラーが分かれているため、この設定は学習用ボットだけを遮断する形になる。数字はいずれもCloudflare経由のサイトとクローラーの統計で、Web全体の比率とは別である。一次資料はCloudflareのプレスリリースと公式ブログ (現地時間2026年9月15日(火))。
運営: AI Quotidia 編集部
海外 AI ニュースを毎朝、日本語で解説する個人運営メディアです。記事は AI を活用して作成し、人手による確認・編集を経て公開しています。